业务标签稳定、请求量增加以后,可以考虑用小模型处理高频的意图分类任务,减少通用模型的调用。选择小模型之前,需要明确它要区分哪些类别,以及这些类别之间的差别。
本文先冻结句向量编码器,训练分类头,再通过知识蒸馏训练一个基于字符特征的轻量分类器,比较两者的分类效果、推理耗时和权重大小。训练脚本、配置、学生权重与结果均在配套工程中。
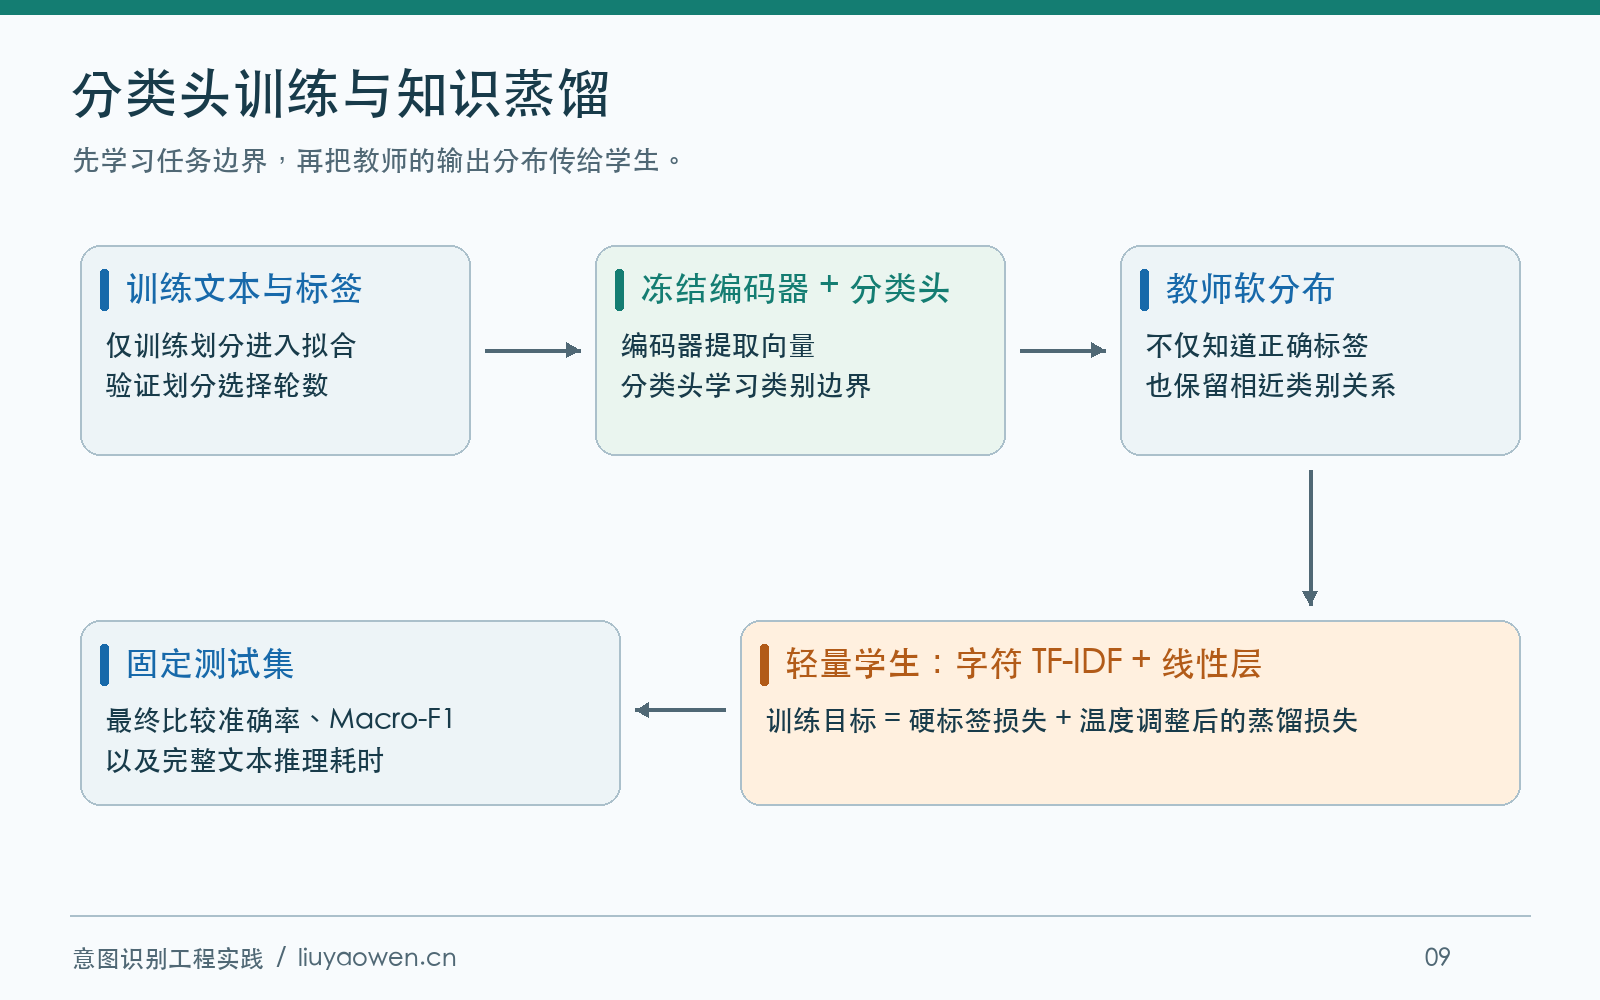
冻结编码器、训练分类头并蒸馏到轻量学生的流程
一、理解训练目标
编码器把文本变成向量,分类头把向量变成标签分数。编码器提取文本特征,分类头根据这些特征区分业务类别。
设编码器输出 h = encoder(text),线性分类头为:
z = W h + b
p = softmax(z)
L = -log p[正确类别]
训练分类头时,梯度更新 W 和 b,编码器保持不变。这样可以先把训练文本编码一次,随后反复训练很小的矩阵。通过这种方法,可以较快地验证现有文本向量能否区分这些类别。
如果编码器生成的向量难以区分咨询和操作,仅训练分类头可能不够。此时可以解冻编码器的部分层、训练适配器,或进行全参数微调,让表示也适应目标任务。更新的参数越多,通常越需要足够的训练数据,并合理设置学习率,避免模型丢失原有能力。Sentence Transformers 的训练文档也强调,不同任务需要的“相似”并不完全相同。训练文档
本文实际执行的是冻结编码器、训练分类头。编码器沿用系列中的多语言 MiniLM 句向量模型;新分类头有 3,080 个可训练参数。完整推理仍需要运行编码器,不能把分类头参数量当成整个模型大小。
二、选择数据集
本实验选用 PolyAI 发布的 BANKING77 数据集,从银行卡相关问题中选择八类:卡片到达、预计送达、卡片不可用、非接触支付不可用、支付被拒、支付处理中、不认识的支付、重复扣款。这些类别的主题接近,适合检验模型能否区分相似意图。数据来自原作者仓库,按 CC BY 4.0 保留署名和许可。BANKING77 数据仓库
保留这八类的官方测试划分,共 320 条;从官方训练划分按规范化文本的固定哈希划分训练集与验证集,分别为 870 条和 197 条。拆分规则、原仓库提交和文件哈希保存在下载包中。
本节用英文银行问题演示训练方法;酒店助手沿用前文的中文标签。两套数据的训练和评测结果分别记录。
类别选择和超参数在训练前固定。验证集用于选择训练轮数,测试集只参与最终比较。最近邻索引和字符词表也都从训练数据建立。
三、训练分类头
“卡片没有送到”和“卡片通常多久送到”词面很接近,但一个偏向当前配送问题,一个询问预计时间。编码器先将文本转换为向量,分类头再根据标注学习两类问题的差别。
如果某个维度更常出现在配送状态问题上,训练会调整相应类别的权重;预测错时,交叉熵推动正确类别分数上升,并压低竞争类别。这个过程同时使用所有类别的信息,并非给每类维护一个关键词表。
核心训练代码如下。完整代码还会根据验证集选择模型,设置随机种子并保存结果:
head = torch.nn.Linear(384, 8)
optimizer = torch.optim.AdamW(head.parameters(), lr=0.03, weight_decay=0.01)

logits = head(train_embeddings)
loss = torch.nn.functional.cross_entropy(logits, train_labels)
optimizer.zero_grad()
loss.backward()
optimizer.step()
只训练分类头时,train_embeddings 可以缓存。解冻编码器以后则不能继续沿用不变的向量缓存,因为每轮更新都会改变文本表示。
处理类别不平衡时,先看每类样本和错误分布。重采样或设置类别权重可以提高低频类别对训练结果的影响,但也会改变模型面对真实频率时的行为。困难负例应围绕相近目标构造,而不只是随意加入大量无关文本。
四、知识蒸馏的原理与实现
假设一个教师对某句输入给出:配送状态 0.65、预计时间 0.30、其他类别共 0.05。硬标签只告诉学生“配送状态正确”;软分布还告诉学生,这句话与预计时间相近,而与其他类别更远。
蒸馏让学生同时学习人工标签与教师的相对判断。本文的学生使用字符 2 到 4 gram 的 TF-IDF 特征,最多 4,000 维,再接一个八类线性层。它不运行句向量编码器,因此推理路径更短。
训练目标写成:
L = α × CE(学生输出, 真实标签)
  + (1 - α) × T² × KL(教师软分布 || 学生软分布)
温度 T 在 softmax 前缩放 logits,使分布更平缓,帮助学生学习次高类别之间的概率差异。教师与学生使用相同温度;常见实现再乘 T² 调整梯度量级。本文固定 T=2、α=0.5,同时训练一个只用硬标签的学生作为对照。PyTorch 蒸馏教程
hard_loss = F.cross_entropy(student_logits, labels)
soft_loss = F.kl_div(
    F.log_softmax(student_logits / 2, dim=-1),
    F.softmax(teacher_logits / 2, dim=-1),
    reduction="batchmean",
)
loss = 0.5 * hard_loss + 0.5 * 4 * soft_loss
教师参数保持冻结,软标签只从训练输入产生。保留真实标签损失很重要:教师也会判断错误,学生不应把教师的每个偏好都当作事实。
五、比较分类效果与推理速度
下表来自固定的 320 条测试输入。分类头和两个学生都运行了三个随机种子;本次三个种子的离散预测指标相同。表中延迟使用种子 42 的模型,在 CPU 预热后逐条处理 40 条文本,包含特征提取与分类:
| 方法 | 正确数 / 320 | Macro-F1 | 单条推理中位数 |
|---|---|---|---|
| 句向量最近邻 | 301/320 | 0.941 | 本组未单列计时 |
| 冻结编码器 + 分类头 | 306/320 | 0.956 | 5.518 ms |
| 学生:只用硬标签 | 289/320 | 0.903 | 0.099 ms |
| 学生:加入蒸馏 | 298/320 | 0.931 | 0.091 ms |
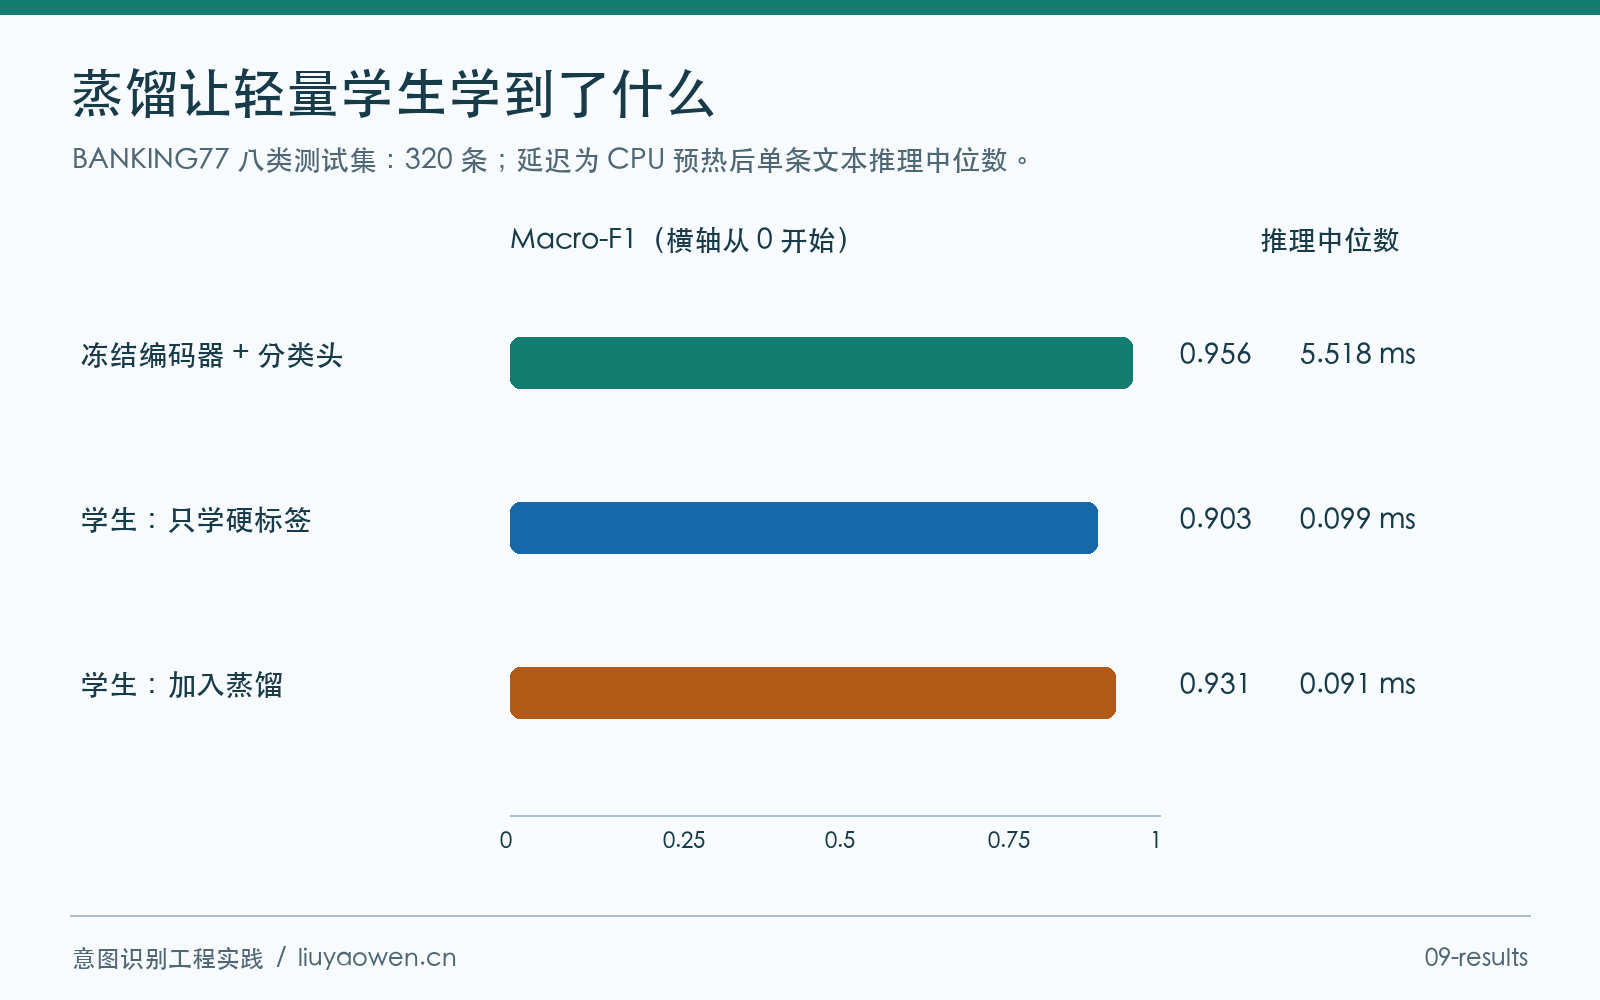
教师、硬标签学生和蒸馏学生的 Macro-F1 与推理耗时
只用硬标签的学生判断正确 289 条,加入蒸馏后为 298 条。教师判断正确 306 条,蒸馏后的学生仍有差距,但比只用硬标签训练的学生更接近教师。蒸馏学生与硬标签学生结构相同,推理时都不再调用教师;蒸馏增加的是训练阶段的监督信息。
选择部署方案时,需要同时比较分类效果和计算成本。两个学生模型的耗时都接近 0.1 毫秒,这次测量不足以说明同样结构的蒸馏学生速度更快。
六、权重量化与存储压缩
浮点权重通常使用 32 位表示;对权重按一定尺度映射到 8 位整数,可以减少存储。本文为每个输出类别分别计算尺度:
scale = max(abs(w)) / 127
q = round(w / scale)
近似恢复:w ≈ q × scale
本次学生的压缩权重文件从 117,734 字节降到 29,342 字节,320 条测试输入上的最终分类指标保持一致。这里统计的是权重文件,不包含字符词表、IDF、Python 运行时和依赖。
附件的 int8 示例在加载后先恢复为浮点权重,再执行矩阵运算,因此展示的是存储压缩。真正的整数推理还需要支持相应算子的运行时;量化后是否更快,要重新测完整推理链,而不能由位宽直接推断。
量化影响的通常是靠近决策边界的输入。除了总分,还应检查预测变化的样本、低频类别和高代价动作。更激进的量化也可以使用校准数据或量化感知训练,但应与当前任务一起验证。
七、模型部署与版本管理
这个八类分类器总会输出一个已知标签。部署到真实入口以后,需要另行识别范围外请求,或者通过阈值、分差与其他判定模块决定是否接收。闭集分类训练不会自然赋予模型“这些类别都不适合”的能力。
增加标签时,还需要同步调整训练数据和部署配置。新旧类别边界、训练样本、类别顺序、模型输出和路由映射都要一起更新。历史模型可能依赖旧类别顺序;如果加载了新标签文件,分数位置与标签名称就会错位。
模型包至少保存标签列表、特征配置、权重、阈值策略、数据版本与运行依赖。更新时用固定回归集检查旧能力,再灰度观察新表达。如果教师来自 LLM 辅助标注,还要抽查标签定义是否被一致执行,尤其是咨询与操作的边界。
八、运行训练与推理代码
从工程根目录运行:
python -m pip install -r batch2/requirements.txt
python batch3/prepare_banking.py
python batch3/train_small.py
python batch3/infer_small.py "My card was charged twice"
python batch3/infer_small.py "My card was charged twice" --int8-storage
最后两条命令直接加载附带的学生权重,不需要运行教师。训练配置在 batch3/training-config.json,数据说明与许可在 batch3/data/,完整结果在 batch3/results/small-model.json。
选择小模型时,先明确要保留的能力和可接受的错误,再比较训练、蒸馏与部署方案。具体怎样把分类结果送进业务流程,见意图路由;怎样持续观察模型变化,见服务上线与错误闭环。