一个识别器在脚本中能返回正确标签,接入服务后仍可能出现另一类问题:请求超时被重复提交,两次回复覆盖同一会话状态,用户已经改了日期,迟到的结果却仍然按旧参数执行。
处理这些问题,需要关注从接收请求到保存结果的整个过程。本文介绍请求标识、状态版本、幂等、超时、缓存和错误样本处理,并提供本地 HTTP 服务供运行和测试。下载服务与故障用例。
请求去重、状态检查、业务判断与原子提交的流程
一、设计请求接口
一个有状态的识别请求,除了文本,还需要知道它属于哪个会话、是不是重试,以及基于哪个状态版本产生。
{
  "session_id": "hotel-demo",
  "request_id": "turn-002",
  "expected_version": 1,
  "text": "北京 2026-10-01 2026-10-03",
  "budget_ms": 2000
}
session_id 定位会话,request_id 标识一次逻辑请求,expected_version 表示调用方看到的状态版本。三个字段不能互相替代:同一会话有很多请求,同一请求可能发送多次,多个不同请求也可能基于同一个旧版本。
真实服务还需要从认证上下文获取用户身份,将会话和业务对象绑定到该身份。请求正文里的用户自述不能替代认证。本地附件固定使用演示身份,接口只监听回环地址,方便读者验证流程。
二、请求幂等与状态版本
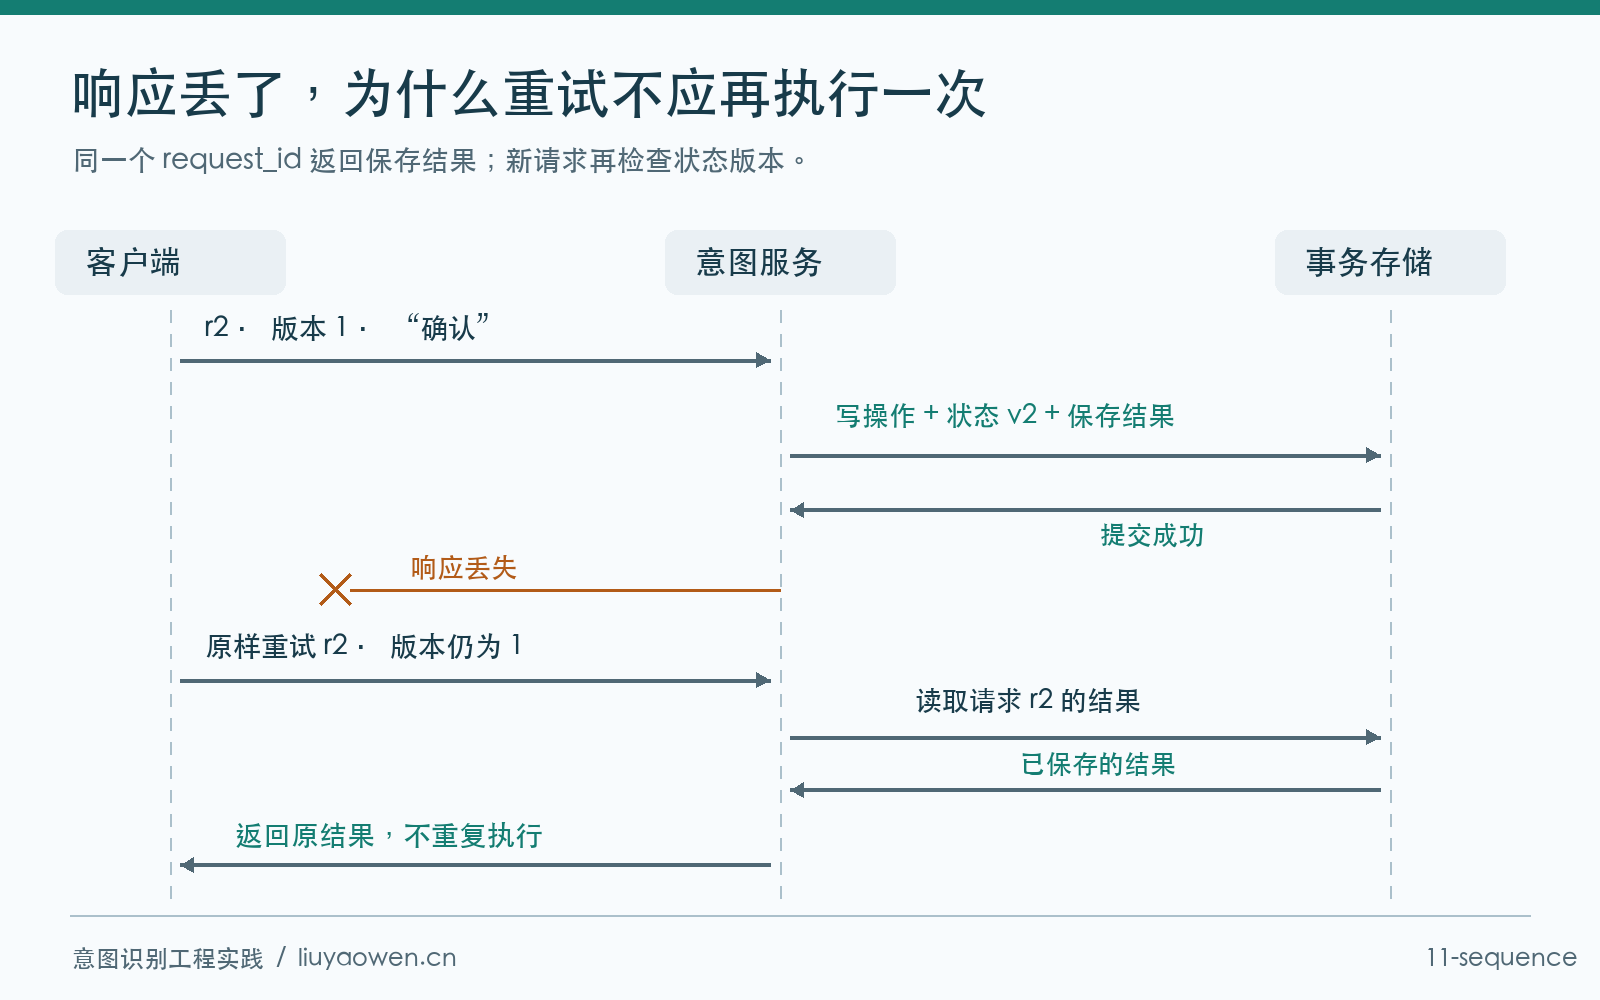
第一次请求已经成功,但响应在网络中丢失。客户端重试时,应沿用原来的 request_id。服务端发现这次逻辑请求已经完成,直接返回保存的结果,而不再次更新状态或取消订单。
如果同一个请求 ID 带来了不同文本,就不是正常重试。可以保存请求关键字段的指纹,发现不同内容时返回冲突,避免旧结果被错误用于新需求。
状态版本处理另一种情况:两条不同请求都基于版本 3,一条修改日期,另一条确认预订。若修改先提交到版本 4,确认就不能继续覆盖版本 4。条件更新应明确要求当前版本仍为 3,否则返回冲突,让客户端重新读取状态。
| 情况 | 合理行为 |
|---|---|
| 同请求 ID、同内容,已有结果 | 返回原结果 |
| 同请求 ID、不同内容 | 幂等冲突 |
| 新请求 ID、状态版本过旧 | 状态冲突 |
| 新请求 ID、版本匹配 | 继续处理并提交新版本 |
检查顺序也重要。正常重试携带的旧版本,可能已经被第一次成功请求推进。因此应先检查已完成的请求记录,再判断新请求是否基于过期状态。
三、用事务保证数据一致性
如果服务先更新状态、后保存去重记录,中间崩溃,重试时就可能再次执行。附件把会话状态、请求结果、审计事件和模拟订单操作放进同一个 SQLite 事务:要么全部保存,要么全部回滚。
SQLite 提供事务和提交、回滚机制,适合演示这些状态之间的一致性关系。Python sqlite3 文档
真实订单系统通常在另一个服务中,不能直接加入本地数据库事务。此时至少需要将逻辑操作 ID 传给工具,让工具自身支持幂等;如果调用超时,先按操作 ID 查询结果,再决定是否重试。必要时用 outbox、任务状态机和结果对账处理跨系统的一致性。
特别要区分“调用返回失败”和“业务操作没有发生”。连接在提交后断开时,两者可能不同。立即换一个新请求 ID 再调用,会绕过去重机制,产生重复操作。
四、设置超时与重试策略
一个请求的总预算为两秒,不能让检索、模型和工具每一步都各自等待两秒。应保存绝对截止时间,每一步计算剩余预算,再决定是否继续、降级或返回明确的服务结果。
可以将总耗时拆成:排队、读取状态、识别、检索或工具、提交与响应。只有拆开,才知道优化模型是否能改善用户体验。如果一半时间耗在排队,单独压缩模型推理的收益就有限。
重试会消耗剩余预算,还会增加系统负载。适合重试的通常是短暂网络或服务故障;参数错误、权限拒绝、状态冲突往往需要改变请求。指数退避和随机抖动可以避免大量客户端同步重试,但仍需设置次数上限,并确保操作适合重试。AWS 超时、重试与抖动说明
附件使用单调时钟在处理节点检查截止时间,超出预算则回滚。这是协作式预算检查:正在阻塞的网络调用仍需要客户端超时;CPU 推理若要强制取消,则需要可中断执行单元或进程隔离。请求中的预算字段需要配合这些执行机制,才能限制实际耗时。
五、事务锁与并发控制
示例代码把整个请求的本地处理放在同一事务中,便于演示状态与模拟订单如何一起提交。模型推理较慢时,事务会持续占用锁,因此高并发服务需要调整事务范围。
实际服务可以先读取状态快照,在事务外完成昂贵识别,再以 expected_version 做短事务提交。提交时必须重新核验版本;如果识别期间状态已经变化,就丢弃基于旧快照的结果或重新计算。
写工具还需要更细的任务状态,例如 proposed、confirmed、executing、succeeded、failed、unknown。unknown 表示结果尚待对账,不能当成明确失败。将这几个状态分开,恢复逻辑才知道应该重新调用、查询结果还是等待用户处理。
Python 标准库 HTTP 服务可用于本地演示;正式部署应选择适合认证、并发、连接管理与可观测性的服务器,并设置反向代理与资源限制。http.server 文档
六、设计缓存键与失效策略
两个用户都输入“1”,可能选择不同订单;同一个用户前后输入“改成明天”,也可能修改不同任务。只按文本缓存识别结果,会把一个语境下的解释带到另一个语境。
缓存键应覆盖所有会影响结果的输入:当前文本、必要的历史或状态摘要、标签版本、模型与 Prompt 版本、语言,以及适当的用户或租户隔离信息。摘要不同可能导致判断不同,摘要策略版本也应纳入版本组合。
识别缓存与业务结果缓存还应分开。缓存一个政策分类候选,与缓存一笔订单的当前状态,具有不同的有效期和失效条件。更不能把“曾经确认过取消”当作可无限复用的确认缓存。
如果身份边界或状态依赖很难明确,先不缓存通常比使用错误缓存更容易维护。先测出成本热点,再决定缓存哪一层。
七、服务监控与业务指标
单看每秒请求数和错误码,很难发现模型把咨询路由成操作。可以把观测分成三个视角:
| 视角 | 关注内容 | 用途 |
|---|---|---|
| 服务 | 延迟分布、超时、排队、依赖失败 | 定位运行瓶颈 |
| 决策 | 标签分布、拒识、澄清、升级模型比例 | 观察输入与策略变化 |
| 任务 | 完成、放弃、人工接管、重复与错误操作 | 判断实际用户结果 |
每次请求记录标签、模型、Prompt、路由和状态版本,才能把变化对应到具体发布。日志中保存足以诊断的结构化字段,原始对话按明确的权限、脱敏和保留策略处理;不要默认把全部聊天与业务参数写入公共日志。
本地示例的审计表只保存会话与请求标识、版本、路由和耗时。生产环境可再连接 trace ID、工具操作 ID 和用户反馈,形成跨服务的请求链。
八、错误样本复核与版本发布
用户纠正“我不是要取消”,是有价值的错误信号,但仍要回看上下文:模型是否误解,界面是否展示不清,还是用户临时改变了主意?
可以先收集信号,再按错误类型分组,复核标签与预期动作,加入训练或回归数据。将线上所有失败自动标成某一类,会把工具故障、产品问题和用户改口混进识别训练。
发布时保存一组可回滚的版本:标签、数据、Prompt、模型、阈值和路由。影子模式只比较新旧输出,不执行新方案的业务写操作;灰度时逐步开放真实流量,并持续观察高代价错误。更新模型后,还需要验证完整业务流程。
九、启动与测试 HTTP 服务
python batch3/service.py --db /tmp/intent-demo.sqlite3 --port 8765
另一个终端发起请求:
curl http://127.0.0.1:8765/turn \
  -H 'Content-Type: application/json' \
  -d '{"session_id":"demo","request_id":"r1","expected_version":0,"text":"取消订单 DEMO-A"}'
系统先返回 confirm。用新的请求 ID、返回的版本和文本“确认”继续,才会完成模拟操作。重复发送完全相同的确认请求,会返回第一次保存的结果。
也可以直接运行自动检查:
python batch3/tests.py
python batch3/http_smoke.py
本次真实回环 HTTP 检查得到:提出方案与确认成功返回 200,原请求重放返回相同结果,旧版本新请求返回 409,同一 ID 换内容返回 409,多余字段返回 400。故障测试还检查了超时回滚、订单版本变化、费用条件变化和重启后的状态恢复。
下一篇完整助手项目把标签、识别、状态、路由和这些服务约束连接起来,给出从安装到完整对话的运行路径。