業務ラベルが安定し、リクエスト量も増えてきたら、小モデルで高頻度に発生する意図分類タスクを処理し、汎用モデルの呼び出し回数を減らすことを検討できる。小モデルを選ぶ前に、分類するカテゴリと、そのカテゴリ間の違いを明確にしておく必要がある。
本稿では、まず文ベクトル用エンコーダーを固定して分類ヘッドを学習し、次に知識蒸留によって文字特徴ベースの軽量な分類器(生徒モデル)を学習する。両者の分類性能、推論時間、重みサイズを比較する。学習スクリプト、設定、生徒モデルの重み、結果はすべて関連プロジェクトにある。
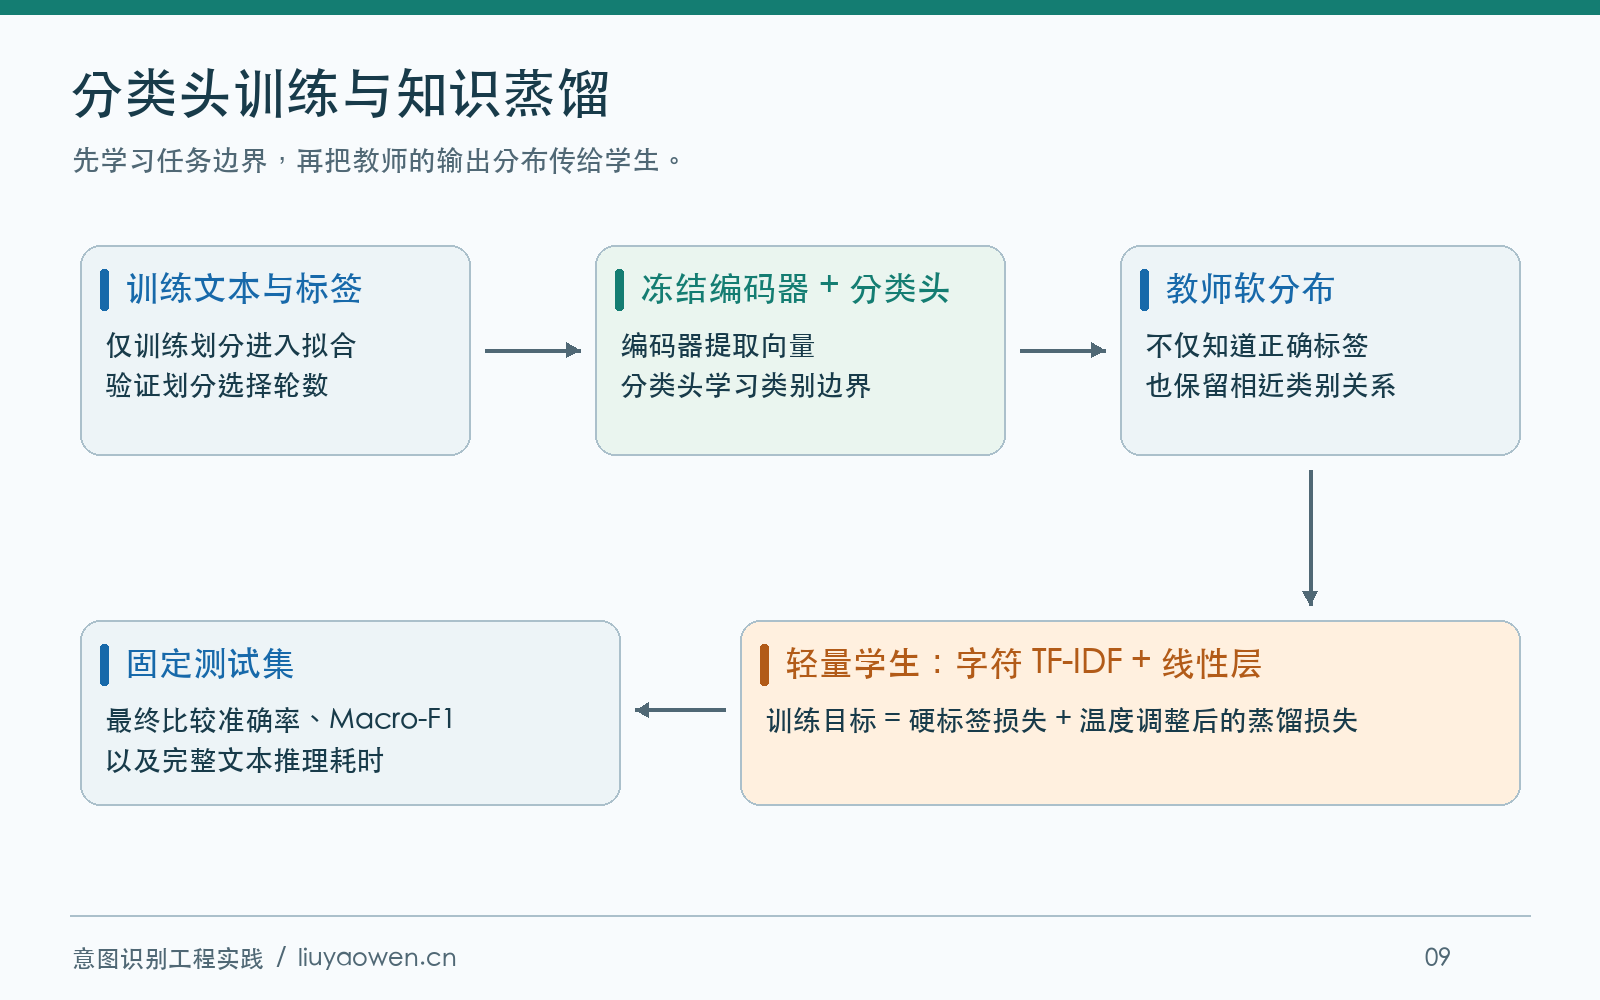
エンコーダーを固定し、分類ヘッドを学習して軽量な生徒モデルへ蒸留するフロー
一、学習目標を理解する
エンコーダーはテキストをベクトルに変換し、分類ヘッドはそのベクトルを各ラベルのスコアに変換する。エンコーダーがテキストの特徴を抽出し、分類ヘッドがその特徴に基づいて業務カテゴリを分類する。
エンコーダーの出力を h = encoder(text) とすると、線形分類ヘッドは次のようになる。
z = W h + b
p = softmax(z)
L = -log p[正确类别]
分類ヘッドを学習するときは、勾配を使って W と b を更新し、エンコーダーは変更しない。这样すれば、訓練テキストのエンコードは一度だけで済み、あとは小さな行列を何度も学習できる。この方法なら、既存のテキストベクトルでこれらのカテゴリを識別できるかを比較的早く検証できる。
エンコーダーが生成するベクトルでは「問い合わせ」と「操作」を区別しにくい場合、分類ヘッドだけを学習しても不十分なことがある。この場合は、エンコーダーの一部の層の固定を解除したり、アダプターを学習したり、全パラメータをファインチューニングして、表現そのものも対象タスクに適合させる。更新するパラメータが多いほど、通常は十分な学習データが必要になり、モデルが元の能力を失わないよう学習率も適切に設定する必要がある。Sentence Transformers の学習ドキュメントでも、タスクごとに必要となる「類似性」が同じとは限らないことが強調されている。学習ドキュメント
実際に採用するのはエンコーダーを固定し、分類ヘッドを学習する方式である。エンコーダーには、本シリーズで用いた多言語 MiniLM の文ベクトルモデルをそのまま使う。新しい分類ヘッドの学習可能なパラメータ数は 3,080 個。完全な推論には依然としてエンコーダーの実行が必要なので、分類ヘッドの参数量をモデル全体のサイズとみなしてはいけない。
二、データセットを選ぶ
本実験では、PolyAI が公開した BANKING77 データセットを使い、銀行カードに関する質問から 8 カテゴリを選んだ。具体的には、カード到着、到着予定、カード利用不可、非接触決済利用不可、支払拒否、支払い処理中、認識できない支払い、二重請求を選んだ。いずれもテーマが近いので、モデルが類似した意図を区別できるかを試すのに適している。データは原作者のリポジトリから取得し、CC BY 4.0 に基づいて出典表示とライセンスを保持している。BANKING77 データリポジトリ
この 8 カテゴリについては公式のテスト分割をそのまま使い、合計 320 件。公式の学習分割は、正規化したテキストの固定ハッシュに基づいて学習データと検証データに分けた。学習データは 870 件、検証データは 197 件。分割ルール、元のリポジトリのコミット、ファイルハッシュはダウンロードパッケージに収録している。
この節では、英語の銀行業務に関する質問を使って学習方法を示す。一方、ホテルアシスタントは前編で使った中国語のラベルを引き継ぐ。2 つのデータセットの学習・評価結果は別々に記録した。
カテゴリ選択とハイパーパラメータは学習前に固定した。検証データで学習エポック数を選び、テストデータは最終比較にだけ使う。最近傍インデックスと文字ボキャブラリーも学習データから構築する。
三、分類ヘッドを学習する
「カードが届いていない」と「カード通常はどのくらいで届くのか」は、字面が近いが、前者は現在の配送状況を、後者は到着予定時間を尋ねている。エンコーダーがテキストをベクトルに変換し、分類ヘッドがラベル付けされたデータに基づいて 2 つの質問の違いを学習する。
配送状態に関する質問に特定の次元がよく現れる場合、学習によって対応するカテゴリの重みが調整される。予測を誤ったとき、クロスエントロピーによって正解カテゴリのスコアが上がり、競合カテゴリのスコアが下がる。この処理ではすべてのカテゴリの情報が同時に使われ、カテゴリごとにキーワード表を維持しているわけではない。
主要な学習コードは次のとおりだ。完全なコードには、検証データによるモデル選択、ランダムシードの固定、結果の保存も含まれている。
分類ヘッドだけを学習する間は、train_embeddings をキャッシュできる。エンコーダーの一部の層の固定を解除した後は、変化しないベクトルのキャッシュを使い続けることはできない。学習のたびにテキスト表現が変わるためだ。
カテゴリの不均衡を扱う際は、まずカテゴリごとのサンプル数と誤り分布を確認する。再サンプリングやカテゴリ重みの設定によって少数カテゴリの学習への寄与を増やせる一方、モデルが実際のカテゴリ頻度に対してとる行動も変わる。ハードな負例は、対象に近いものを中心に構築すべきで、単に無関係なテキストを大量に加えるだけでは不十分である。
四、知識蒸留の原理と実装
ある教師モデルが、入力文に対して「配送状況 0.65、到着予定時間 0.30、その他カテゴリ合計 0.05」と出力したとする。ハードラベルは生徒モデルに「配送状況」が正解であることしか示さない。ソフト分布なら、この文では「到着予定時間」の相対確率も高く、他のカテゴリはさらに低い、という情報も伝えられる。
蒸留により、生徒モデルは人手によるラベルと教師モデルの相対的な判断を同時に学習する。本稿の生徒モデルは、文字の 2〜4 gram に基づく TF-IDF 特徴を最大 4,000 次元で抽出し、8 クラスの線形層を接続する。文ベクトル用エンコーダーは実行しないため、推論経路は短くなる。
学習目標は次のように表せる。
L = α × CE(学生输出, 真实标签)
  + (1 - α) × T² × KL(教师软分布 || 学生软分布)
温度 T は softmax の前に logits のスケールを調整し、分布を平坦にすることで、生徒モデルが第2位以降のカテゴリにある確率差を学習する助けになる。教師モデルと生徒モデルには同じ温度を使う。一般的な実装では、勾配のスケールを調整するため、さらに T² を掛ける。本稿では T=2、α=0.5 とし、対照実験用としてハードラベルのみを学習する生徒モデルも作成する。PyTorch 蒸留チュートリアル
教師モデルのパラメータは固定したままとし、ソフトラベルは学習入力からのみ生成する。実ラベルの損失を保つことが重要なのは、教師モデルも誤判定することがあり、生徒モデルが教師の好みをすべて事実として扱うべきではないからだ。
五、分類性能と推論速度を比較する
以下の表は、固定した 320 件のテスト入力に基づく。分類ヘッドと 2 つの生徒モデルは、いずれも 3 つのランダムシードで実行し、今回は 3 つのシードすべてで予測結果に基づく指標が一致した。表のレイテンシはシード 42 のモデルを使い、CPU をウォームアップしたうえで、特徴抽出と分類を含めて 40 件のテキストを 1 件ずつ処理して測定した。
| 方法 | 正解数 / 320 | Macro-F1 | 1 件あたりの推論時間の中央値 |
|---|---|---|---|
| 文ベクトル最近傍 | 301/320 | 0.941 | このグループでは個別に計測していない |
| 固定エンコーダー + 分類ヘッド | 306/320 | 0.956 | 5.518 ms |
| 生徒:ハードラベルのみ | 289/320 | 0.903 | 0.099 ms |
| 生徒:蒸留を追加 | 298/320 | 0.931 | 0.091 ms |
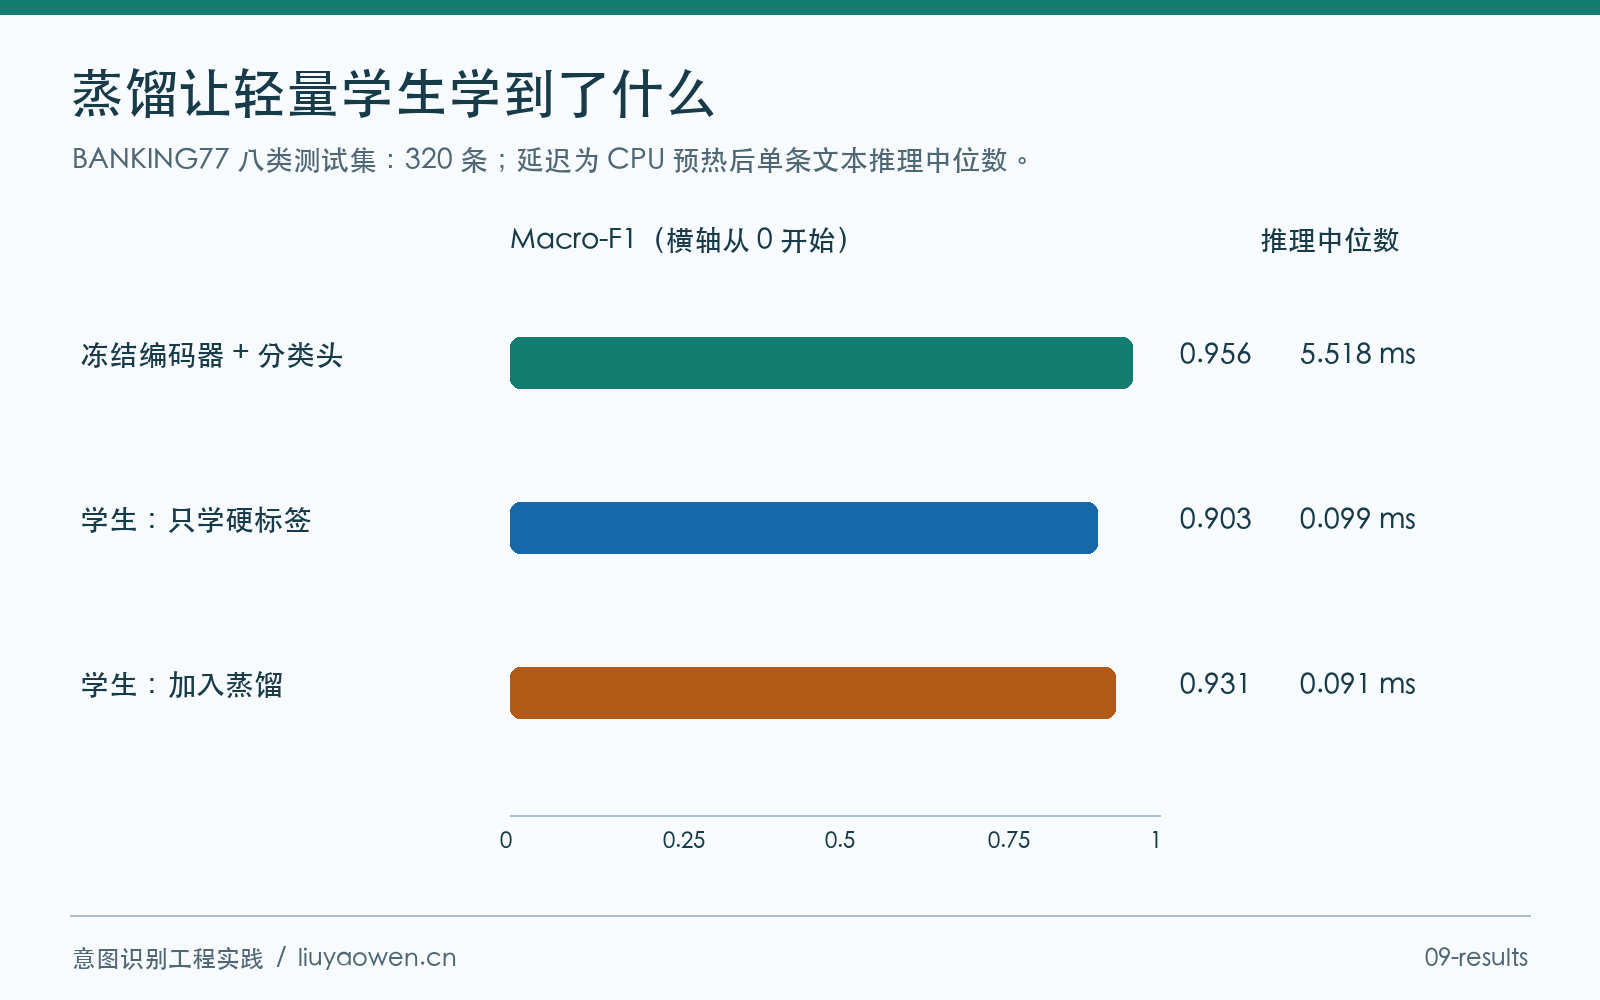
教師モデル、ハードラベルの生徒モデル、蒸留済みの生徒モデルの Macro-F1 と推論時間
ハードラベルのみの生徒モデルは 289 件を正しく判定し、蒸留を追加すると 298 件になった。教師モデルは 306 件を正しく判定しており、蒸留済みの生徒モデルにはまだ差がある。ただし、ハードラベルのみで学習した生徒モデルよりは教師モデルに近い。蒸留済み生徒モデルとハードラベルの生徒モデルは構造が同じで、推論時にどちらも教師モデルを呼び出さない。蒸留によって増えるのは、学習段階での教師信号だ。
配備方式を選ぶときは、分類性能と計算コストを同時に比較する。2 つの生徒モデルはいずれも 1 件あたり 0.1 ミリ秒近く、今回の測定だけでは、同じ構造の蒸留済み生徒モデルが高速だと断定できない。
六、重みの量子化とストレージ圧縮
浮動小数点の重みは通常 32 ビットで表現される。重みを所定のスケールで 8 ビットの整数にマッピングすれば、ストレージを削減できる。本稿では、出力カテゴリごとにスケールを計算する。
scale = max(abs(w)) / 127
q = round(w / scale)
近似恢复:w ≈ q × scale
今回の生徒モデルの圧縮済み重みファイルは、117,734 バイトから 29,342 バイトへ縮小した。320 件のテスト入力における最終的な分類指標も変わらない。ここで数えているのは重みファイルだけで、文字ボキャブラリー、IDF、Python ランタイム、依存関係は含まない。
同梱の int8 サンプルは、読み込み後にまず浮動小数点の重みへ戻してから行列演算を実行するため、示しているのはストレージ圧縮である。実際の整数推論には、対応する演算子を扱うランタイムが必要だ。量子化によって速くなるかは、完全な推論チェーンを再度測定する必要があり、ビット幅だけから判断することはできない。
量子化の影響が出やすいのは、意思決定境界に近い入力だ。総合スコアだけでなく、予測が変わったサンプル、少数のカテゴリ、高コストなアクションも確認する。より攻めた量子化では校正データや量子化考慮学習も利用できるが、現在のタスクと併せて検証する必要がある。
七、モデルの配備とバージョン管理
この 8 クラス分類器は、必ず既知のラベルのいずれかを出力する。実際のエントリポイントへ配備した後は、範囲外リクエストを別途認識する必要がある。あるいは、しきい値やスコア差、他の判定モジュールを使って、リクエストを受け付けるかどうかを決める必要がある。閉集合での分類学習だけでは、「どのカテゴリにも該当しない」という判断能力がモデルに自然に付与されるわけではない。
カテゴリを追加するときは、学習データと配備設定も同時に更新する必要がある。新旧カテゴリの境界、学習サンプル、カテゴリ順、モデル出力、ルーティングの対応関係をすべて更新する。過去のモデルは旧来のカテゴリ順に依存している可能性がある。新しいラベルファイルを読み込むと、スコア位置とラベル名がずれる。
モデルパッケージには、少なくともラベル一覧、特徴設定、重み、しきい値戦略、データバージョン、実行時依存関係を保存する。更新時は固定のリグレッションデータセットで従来の能力を確認してから、段階配備して新しい表現を観察する。教師モデルが LLM を活用した補助アノテーションで得られたものなら、ラベル定義が一貫して適用されているかをサンプリング確認する。特に「問い合わせ」と「操作」の境界に注意する。
八、学習と推論のコードを実行する
プロジェクトルートで次を実行する。
最後の 2 つのコマンドは同梱の生徒モデルの重みを直接読み込むため、教師モデルを実行する必要はない。学習設定は batch3/training-config.json、データの説明とライセンスは batch3/data/、完全な結果は batch3/results/small-model.json に置いている。
小モデルを選ぶときは、維持したい能力と許容できる誤りを先に明確にしておき、学習・蒸留・配備の各方式を比較する。分類結果を業務フローに組み込む具体的な方法は意図ルーティング、モデルの変化を継続的に観察する方法はサービス展開とエラー改善ループを参照。