意図認識器の精度が90%から93%に上がっても、アシスタントが使いやすくなったとは限りません。増えた正解がすべて高頻度の問い合わせに由来する場合、注文のキャンセルは依然として誤判定が多いままです。あるいは、モデルがより保守的になり、多数の要求が追加確認に回されたため、受理された要求の精度が上がった可能性もあります。
評価で答えるべき問いはもう少し具体的です。今回の変更で何の能力が向上し、何の代償を伴い、ユーザーがより 쉽게タスクを完了できるようになったのか。本稿では、分類、スロット、対話状態、業務結果の評価方法を示し、そのまま実行できる評価スクリプトも提供します。配套プロジェクトをダウンロード。
一、評価対象と指標
ホテル向けアシスタントは、ユーザーの表現を理解する、対話状態を更新する、処理経路を選ぶ、業務フローを実行するという4つの段階に分けられます。各段階で正しい答えは異なるため、すべての問題を1つの「精度」だけで測ることはできません。
ユーザーが「チェックインを明日に変更」と言ったとき、意図認識では「予約の継続」と判定されることがあります。これは分類上の答えです。状態を更新するときも、都市と部屋タイプを残してチェックイン日だけを変更する必要があります。これは状態上の答えです。最終的な予約には、日付、予約枠、価格、確認条件を満たす必要があります。これはタスク上の答えです。
最終的な予約が成功したかだけを見ると、失敗した場合、どこで問題を起こしたのかが突きにくくなります。ラベルが正しいかだけを見ると、状態が上書きされた、条件が失われた、ツールの実行に失敗した、といった問題を見逃す可能性があります。妥当な評価では、階層別の診断とエンドツーエンドの結果の両方を残します。
| 階層 | 典型的な問題 | 指標またはチェック |
|---|---|---|
| 分類 | ルールに関する相談を操作と誤判定していないか | クラスごとのRecall、Macro-F1、混同行列 |
| 範囲外判定 | サポート対象外の要求を無理に受理していないか | カバレッジ、受理エラー率、範囲外の誤受理 |
| パラメータと状態 | 日付変更が正しいタスクに適用されているか | スロット一致、状態完全一致、タスク紐付け |
| 複数ターンのタスク | ユーザーの目標を実際に完了できているか | 完了率、追加確認の回数、復旧成功率 |
| 業務 | 誤った操作や重複した動作を発生させていないか | 誤操作、重複実行、処理コスト |
二、学習・検証・テストセットの划分
学習セットはモデルの学習に、検証セットはハイパーパラメータと閾値の選択に、テストセットは方式を固めた後の結果確認に使います。3つを分ける基準は、ファイル名だけでなく、それぞれのデータセットが意思決定にどう関わるかです。
ある元の会話から5種類の書き換え generates 場合を考えます。6件のレコードをランダムに学習用とテスト用へ分けると、モデルはテスト中にほぼ同じ表現を再び見る可能性があります。会話、書き換えの系統、ユーザー、ソースなどの関連関係は、まずグループにまとめ、そのうえで分割します。
同じセッション内の「北京のホテルを予約したい」と、その後に続く「明日に変更」を別々の学習・テストセットへ入れると、モデルが新しい会話表現を理解できるかを検証できません。テストで必要な前文は、会話全体と一緒に保存する必要があります。
実作業では、まず各レコードに conversation_id、source_id、family_id を付け、タスクに適したグループ化キーを使って分割します。すでに稼働中のシステムなら、時刻-based splitで新しい表現を観察できます。過去のデータで学習し、その後に得た一定期間のデータでテストします。時間分割でも、同じチケットやセッションが境界をまたがないようにする必要があります。
動的な事例検索は、とくに忘れられがちです。分類器自体がテスト文を学習していない。即使Few-shotの事例ライブラリや最近傍インデックスにテストの正解が含まれていたなら、システム全体がテスト情報を利用したことになります。検索用ライブラリ、プロンプト例、閾値、モデルは、すべて評価対象の構成に含まれます。
三、精度とMacro-F1
精度は、正解した予測数をすべての予測数で割ったものです。分かりやすい指標ですが、各クラスの出現頻度に左右されます。
100件の要求のうち、90件が注文照会、10件が注文のキャンセルだとします。システムをすべて注文照会と予測しても、精度は90%のままですが、キャンセルクラスのRecallは0です。キャンセル処理だけを見れば、このシステムはほとんど識別機能を提供していないことになります。
あるクラスについて、予測結果を「そのクラスに属する」と「属さない」という2つの集合に分けると、次のようになります。
Precision = TP / (TP + FP)
Recall    = TP / (TP + FN)
F1        = 2 × Precision × Recall / (Precision + Recall)
Macro-F1  = 各类别 F1 的算术平均
Precisionは、選ばれた結果に正しいものがどれだけ含まれるかを示します。Recallは、実際に存在する結果をどれほど正しく特定できたかを示します。F1は両方を考慮します。Macro-F1はすべてのクラスに同じ重みを与えるため、低頻度クラスの問題更容易 드러出します。計算時にはラベルの一覧を固定し、予測がない場合とサポートサンプルがない場合の扱いも明示します。scikit-learn F1ドキュメント
先ほどの90/10の例では、照会クラスのF1は約0.947、キャンセルクラスは0、Macro-F1は約0.474です。この数値は、精度が覆い隠していたクラスバイアスを示しています。
ただし、Macro-F1は業務上のコストを自動的には表しません。相談をキャンセルと誤判定した場合と、返金に関する相談を注文照会と誤判定した場合では、結果が異なる可能性があります。高コストのクラスでは、Recall、誤受理、業務フローでの結果を個別に確認する必要があります。
四、混同行列によるエラー分析
混同行列の行は実クラス、列は予測クラスを表します。対角線上の個数が正しく分類された数で、残りのマスは誤りがどの方向に起きたかを示します。
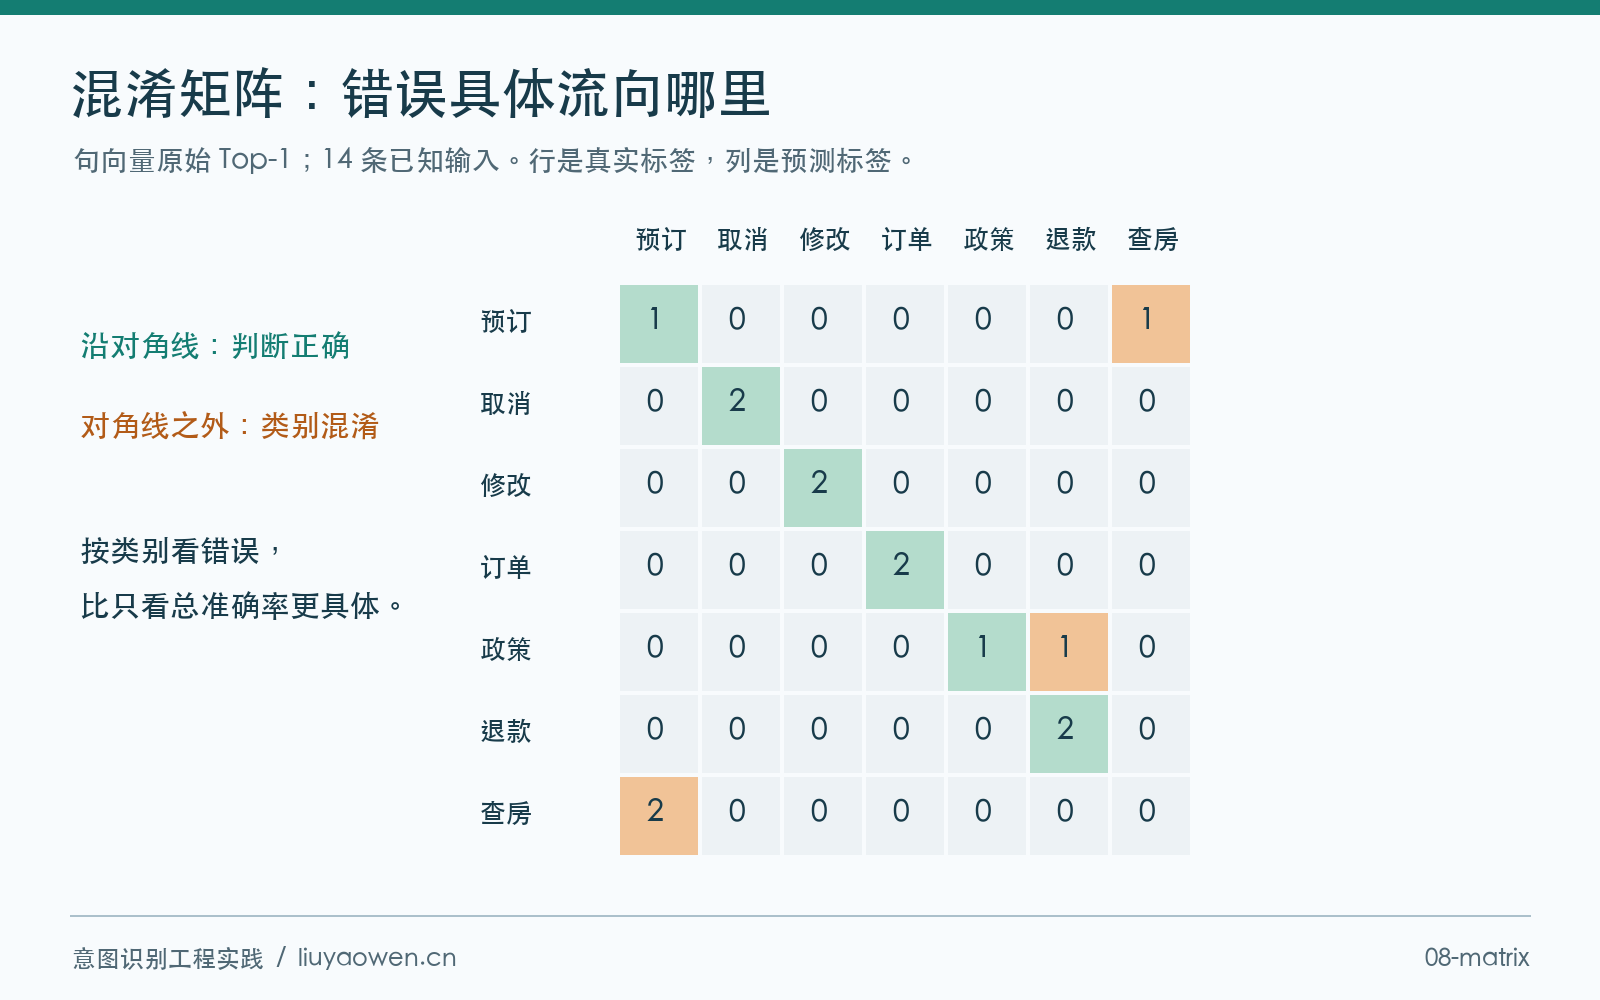
ホテル领域的既知入力における文ベクトルベースラインの混同行列
既存の注文の変更が「空室検索」に分類されやすいなら、モデルが「部屋タイプ」というキーワードだけを捉え、「すでに予約済み」という段階情報を無視していないか確認します。キャンセルルールについての相談が「キャンセル操作」に分類されやすいなら、ポジティブ例とネガティブ例、疑問文・条件・否定表現を確認します。
前回の基本手法による予測結果は、batch3/evaluate.py を使って再計算できます。ここでは、元の分類指標は既知クラスの入力14件だけを対象としており、範囲外判定の指標には全21件の入力を使います。
| 方法 | 元の精度 | Macro-F1 | ポリシーの受理数 |
|---|---|---|---|
| ルール | 0.571 | 0.477 | 10/21 |
| TF-IDF分類器 | 0.643 | 0.558 | 6/21 |
| 文ベクトル近傍 | 0.714 | 0.695 | 4/21 |
この表では、範囲外の要求を分類の正解として数えていません。候補の並べ替えと、候補を受理するかどうかの判断は別のdecisionです。両者を分けて調べないと、ある方式が分類に長けているのか、それとも受理しやすい要求だけを選んだだけなのかを判別できません。
五、カバレッジと範囲外要求の扱い
2つのポリシーを考えます。Aは100件受理して5件誤り、Bは10件受理して誤りはありません。受理したものの精度だけを見ると、Bのほうが優れています。しかし残りの90件を引き続き処理する必要があり、そのせいで多数のユーザーが要望を何度も説明することになります。
そのため、少なくとも次の指標を同時に報告します。
受理したサンプルが1件もない場合、受理エラー率には分母がなく、未定義とします。0%と書いて、優れた結果として扱うことはできません。
閾値をスイープすると、カバレッジとエラー率の関係をグラフに描けます。ただし、その関係Suddenly that smoothで単調とは限りません。有限なサンプルでは、正しい結果や誤った結果を数件除外するだけで、比率が大きく変動することがあります。閾値は検証データと誤りのコストに基づいて選び、固定してからテストでの性能を確認します。テスト結果に合わせて閾値を繰り返し調整しないでください。
六、マルチラベル、スロット、状態の評価
マルチラベルのタスクでは、結果集合として扱えます。予測が {查订单}、真値が {查订单, 退款咨询} なら認識漏れです。キャンセルタスクを1つ多く予測していれば過剰認識です。集合のPrecisionとRecallを計算する一方、集合全体が完全に一致することを要求する方法もあります。
ただし、2つの予約タスクが同じラベルを持つ場合はあります。ラベルの集合だけを比較すると、2つを1つにまとめてしまいます。タスク照合では、タスクの識別情報、重要なパラメータ、依存関係を組み合わせる必要があります。必要なら、予測ノードと正解ノードを先に照合してから、関係を調べます。
スロット照合にも業務上の意味が必要です。「明日」と「2026-10-02」が等しいかは、会話の時刻とタイムゾーンで決まります。「北京市」と「北京」が等しいかは、正規化の規則で決まります。正規化は予測結果と真値の双方に同じ規則を適用し、ある結果を直すために一時的な特別ルールを加えないようにします。
状態の完全一致は、このターンの終了時点に、評価対象の全フィールドが正しいかを調べます。スロットごとの平均値より厳格です。都市、日付、部屋タイプのうち1つでも違えば、状態全体は一致しません。2つの指標を併用すれば、個別のフィールドが改善したことと、状態全体として使えるようになったことを区別できます。
七、複数ターンのタスクの成功基準
アシスタントが「キャンセルしました」と伝えただけでは、キャンセル成功の証拠にはなりません。成功基準はツールの実行結果や業務状態に対応させる必要があります。たとえば、注文のステータスが実際に cancelled に変わり、重複した操作が発生していないことなどが該当します。
同様に、ユーザーが「料金がかかった場合はキャンセルしない」と言った場合、照会して費用が見つかった因而注文を維持したなら、目標を守ったと評価すべきです。単純にキャンセル失敗とは数えません。複数ターンの評価では、各シナリオで許される終端状態を先に定義する必要があります。
条件付きキャンセルのシナリオでは、初期状態の注文、ユーザーの制約、許可する操作、想定される終端状態、禁止する操作を保存できます。会話を実行した後、結果と過程の両方を確認します。必要な情報を追加確認したか、費用を提示したか、誤ってキャンセルしていないか、重複送信していないかを確認します。
追加確認にもコストがあります。タスクの完了率に加えて、平均追加確認回数、同じ不足情報を繰り返し確認した回数、ユーザーがどの段階で諦めたかも記録します。最終的に成功しても、10回も同じ説明を求める必要があるフローなら、明確な改善余地があります。
八、レイテンシとコストの測定
モデルの推論は、エンドツーエンドの所要時間の一部にすぎません。ユーザーが感じる時間には、待ち行列、状態の読み取り、検索、ツール呼び出し、再試行も含まれます。
計測では、まず開始点と終点を定義します。HTTPリクエストが到着してから、最終回答または明示的な追加確認結果が返るまでです。キャッシュヒット、モデルのフォールバック、失敗したリクエスト、タイムアウトもすべて残す必要があります。成功して速やかに返ったリクエストだけで平均値を取ることはできません。
平均値は、合計リソース量の見積もりに役立ちます。P95などの分位数可以看到、分布の末端で起きる体験を把握できます。2つの実装を比較するときは、並列数、入力長、ハードウェア、ウォームアップ方法をそろえる必要があります。呼び出しコストは、完了したタスクごとのコストとして集計し、再試行や大型モデルへのエスカレーションに伴う追加呼び出しも含めます。
このシリーズのローカルプロジェクトでは、機能チェック、モデル分類の実験、サービスリクエストのテストを別々に記録しています。3つはいずれも異なる問いに答えます。ロジックが正しいか、モデルがどう分類するか、リクエストチェーンを契約どおり処理できるか。
九、評価結果に基づく改善
まずエラーをグループ化します。ラベル定義の衝突、表現の網羅性不足、コンテキスト不足、パラメータ紐付けの誤り、閾値が過度に保守的、ルーティングの誤り、ツール障害です。そのうえで、1つのエラーに対応する変更を試し、関連する指標と、影響を受け得る他の指標を観察します。
キャンセルポリシーのネガティブ例を追加するなら、相談とキャンセルの混同を重点的に確認します。状態の要約を変更するなら、指称と短い応答を重点的に確認します。閾値を上げるなら、誤受理とカバレッジの両方を確認します。
複数のランダムシードを使えば、学習初期化の影響を調べられます。ただし、より多様なソースのテストデータを代わりにすることはできません。複数ターンのデータを再サンプリングするときは、セッションを単位にします。同じ会話の各ターンを独立したサンプルとして扱ってはいけません。モデルを答案の評価者にする場合も、まず人手で確認済みのサンプルで評価基準を照合し、評価者が熟悉的な表現を好むだけになるのを防ぎます。
本稿の評価を実行します。
python batch3/evaluate.py
結果は batch3/results/hotel-evaluation.json に保存されます。クラスごとの指標、混同行列、固定したスコア差での閾値スイープが入っています。次に小モデルの学習と蒸留を読むと、評価で明らかになった問題に沿って学習目標を決める方法が分かります。