元記事:Cognition | マルチエージェントを構築しないでください --- Cognition | マルチエージェントを構築しないでください
中核的な考え方と著者の主張
著者指出、現在のLLM(大規模言語モデル)エージェントフレームワークは、実際の性能が期待を下回っている。特に、「マルチエージェント」による連携を謳うアーキテクチャに共通する問題だ。著者は自身とチームの試行錯誤を踏まえ、信頼性が高く長期間動作するエージェントを構築するための基本原則を提示している。そして、一見すると魅力的に見える多エージェントアーキテクチャが、なぜ実践ではこれらの原則に反し、脆くて信頼性にも欠けるシステムにつながるのかを、詳しく説明している。
一、コンテキストエンジニアリングの原則:信頼できるエージェントの基盤
LLMとAIエージェントの時代は、まだ探索の段階にある。初期のWeb開発者がHTMLやCSSの使い方を探っていた頃と同じようなものだ。「コンテキストエンジニアリング」は、高效で信頼できるエージェントを構築する中核であり、従来の「プロンプトエンジニアリング」より一歩踏み込む。動的なシステムでモデルが必要とする正確なコンテキストを自動的に管理し、提供することを重視する。
エージェント構築における2つの基本原則:
コンテキストを共有する:
- 原則の内容: エージェントは、孤立したメッセージや現在の指示だけでなく、全体の「会話履歴」と「意思決定の履歴」にアクセスして理解する必要がある。これは、単一メッセージではなく完全なエージェントトレースを共有する必要があることを意味する。
- 重要性: LLMモデル自体は賢いが、十分なコンテキストがなければ実力を発揮できない。人間も作業の経緯や背景を知るのと同じで、エージェントにもこの情報が必要だ。タスクを取り違えたり、切り離された判断を下したりしないためだ。
- 反例(「マルチエージェント」分業モデルの脆さ):
- アーキテクチャ図:
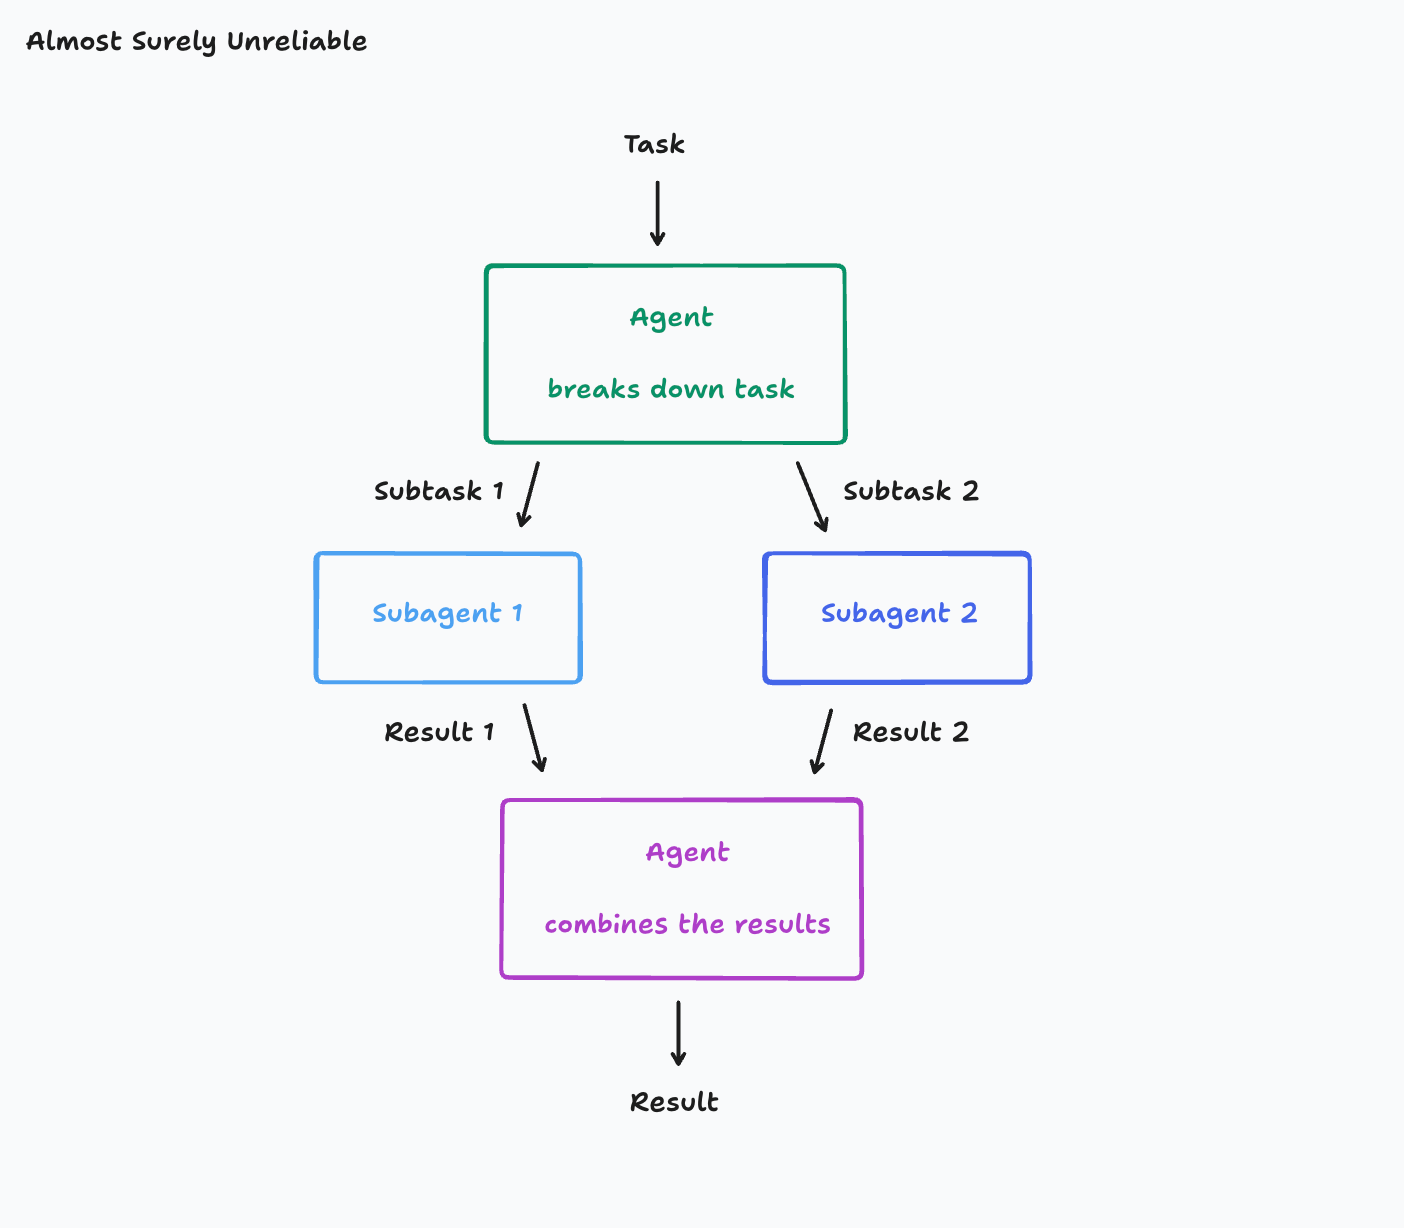
- 例: 仮にタスクが「『Flappy Bird』のクローンを作る」ものだとする。このタスクは、サブタスク1「緑の配管と衝突判定ボックスを備えたモバイルゲーム用背景を作る」とサブタスク2「上下に動く小さな鳥を作る」に分解される。
- 問題点: サブエージェントが自分のサブタスクの指示だけを受け取り、元のタスク全体の説明や、メインエージェントがタスクを分解した際のすべての判断と考慮事項を参照できないなら、誤解を生みやすい。
- サブエージェント1は「背景」のスタイルを取り違え、『スーパーマリオブラザーズ』そっくりの背景を作り始めるかもしれない。
- サブエージェント2が作った鳥は、ゲームの素材として不自然に見え、移動の仕方も『Flappy Bird』の仕組みとまったく違うかもしれない。
- 結果: メインエージェントには、2つの誤解から生まれた成果物(一致しない背景と条件に合わない鳥)を組み合わせる困難な作業が待ち受ける。
- 深い理由: 現実のタスクには、階層を成す細かな違いが多数ある。複数ターンの対話の中で、エージェントはタスクをどう分解すべきか決めるために複数のツール呼び出しを行う必要がある。その詳細が一つでも、サブタスクの解釈に大きな影響を与える。サブエージェントが完全な履歴にアクセスできないと、解釈がずれやすい。
- アーキテクチャ図:
行動には暗黙の判断が含まれる:
- 原則の内容: エージェントのすべての行動には、その時点のコンテキストに基づいて下した暗黙の判断が含まれている。これらの判断が互いに衝突する前提で成り立っているなら、最終的な結果は悪化避けられない。
- 重要性: エージェントの行動は命令の実行にとどまらず、タスクをどう理解しているか、内部でどう考えているかを反映している。これらの暗黙の判断には一貫性が必要だ。
- 反例(並列作業による不整合):
- アーキテクチャ図:
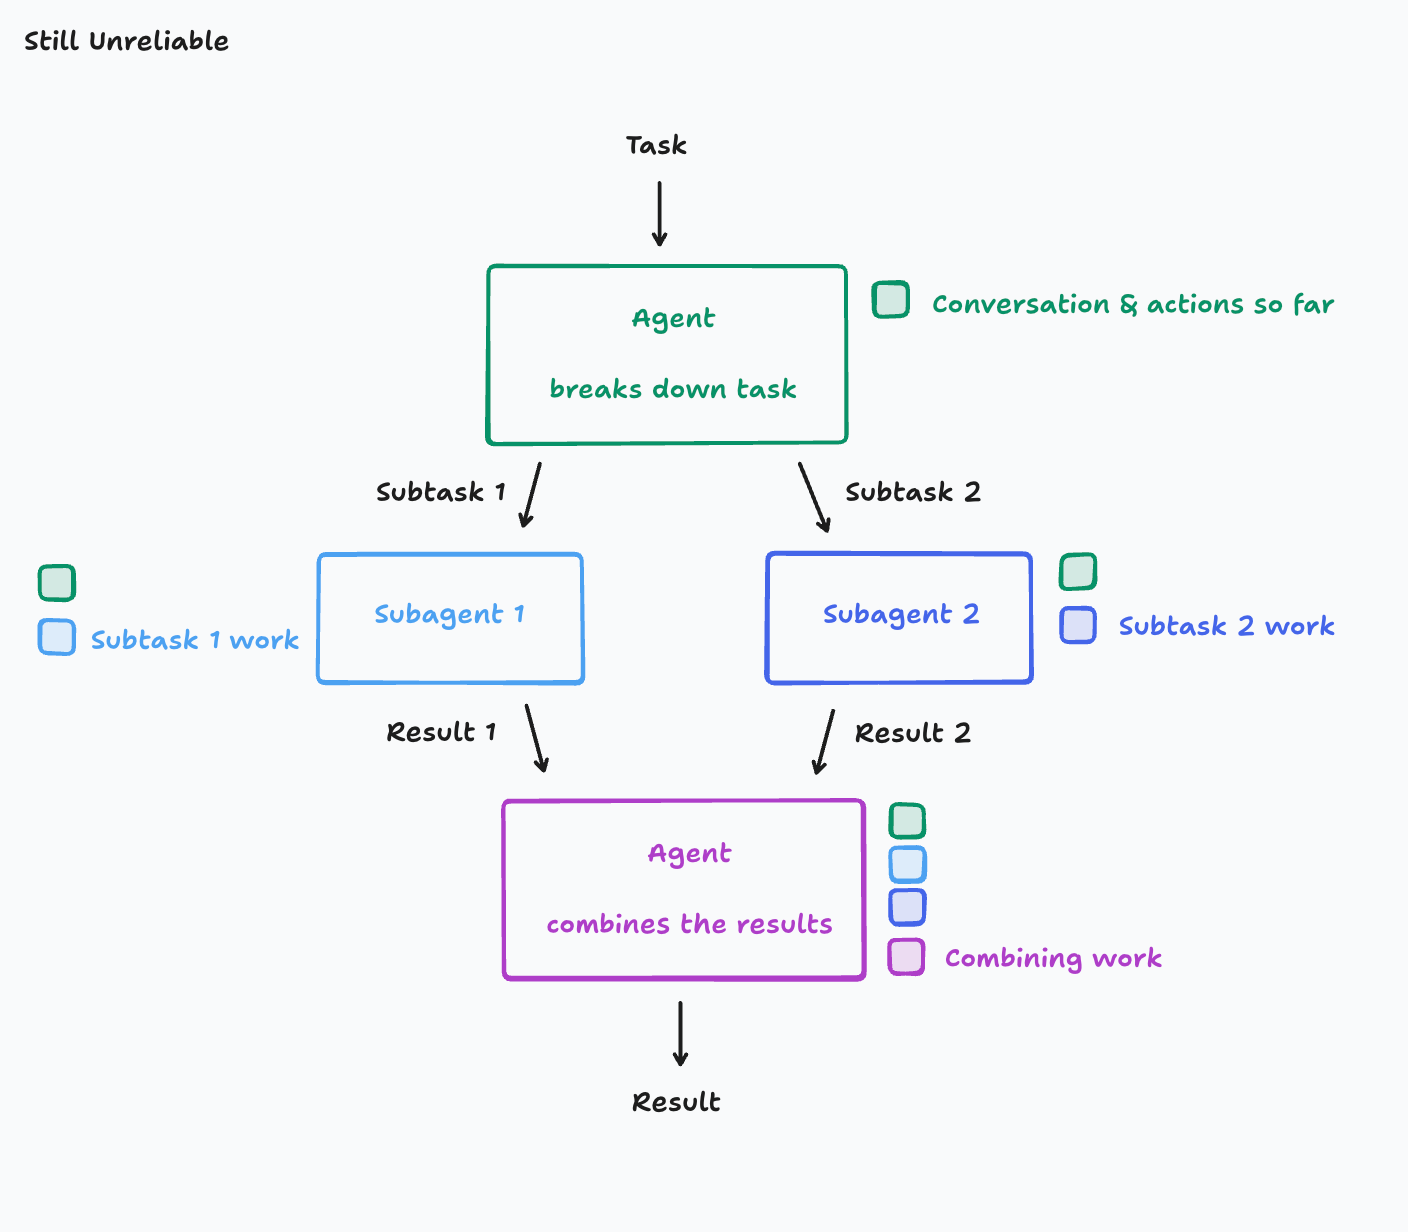
- 例: 各サブエージェントが完全なコンテキストを共有していたとしても(つまり、『Flappy Bird』のクローンを作ることをみんな知っていたとしても)、互いのリアルタイムの進捗を参照できないまま並行して作業すれば、問題仍是起きる。
- サブエージェント1が背景を設計するとき、特定のピクセルアートスタイルを選ぶかもしれない。
- サブエージェント2が鳥を設計するとき、まったく異なるカートンスタイルを選ぶかもしれない。
- 結果: 鳥と背景のビジュアルスタイルがまったく異なる『Flappy Bird』のクローンができる可能性がある。
- 深い理由: サブエージェント1とサブエージェント2の行動は、事前に明示されておらず、リアルタイムで共有もされていない互いに衝突する前提に基づいて決まった。それぞれが对方が何をしているかを見られないため、作業結果は最終的に一致しない。
- アーキテクチャ図:
二、長期間動作するエージェントの理論とベストプラクティス
著者は、この2つの原則はいずれも決定的に重要で、あえて破る価値はほぼないと強調している。そのため、エージェントアーキテクチャを設計する際は、この原則を守らないアーキテクチャを最初から候補から外すようにすべきだ。
1. 最も単純で信頼できるアーキテクチャ:単一スレッドの線形エージェント
- アーキテクチャ図:
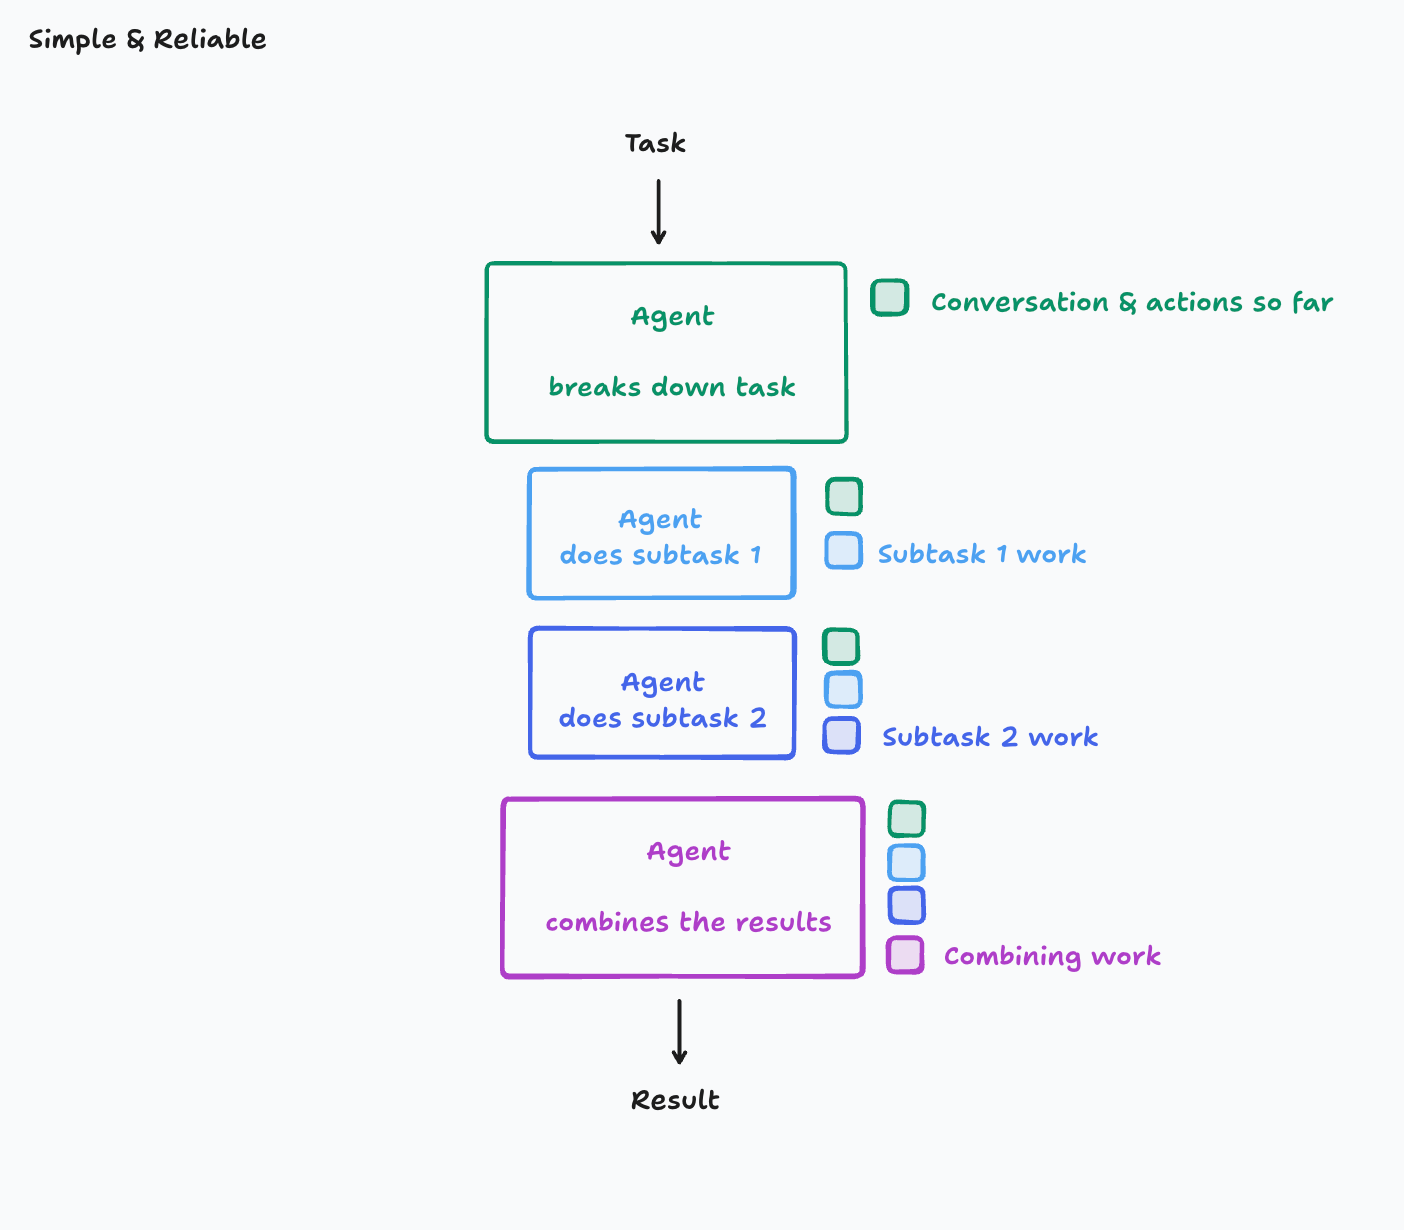
- 利点: このアーキテクチャでは、コンテキストが連続している。各ステップから、それまでのすべての会話・意思決定・ツール呼び出し履歴へ完全にアクセスできる。これにより、エージェントの判断の一貫性が保たれ、信頼性が大きく高まる。
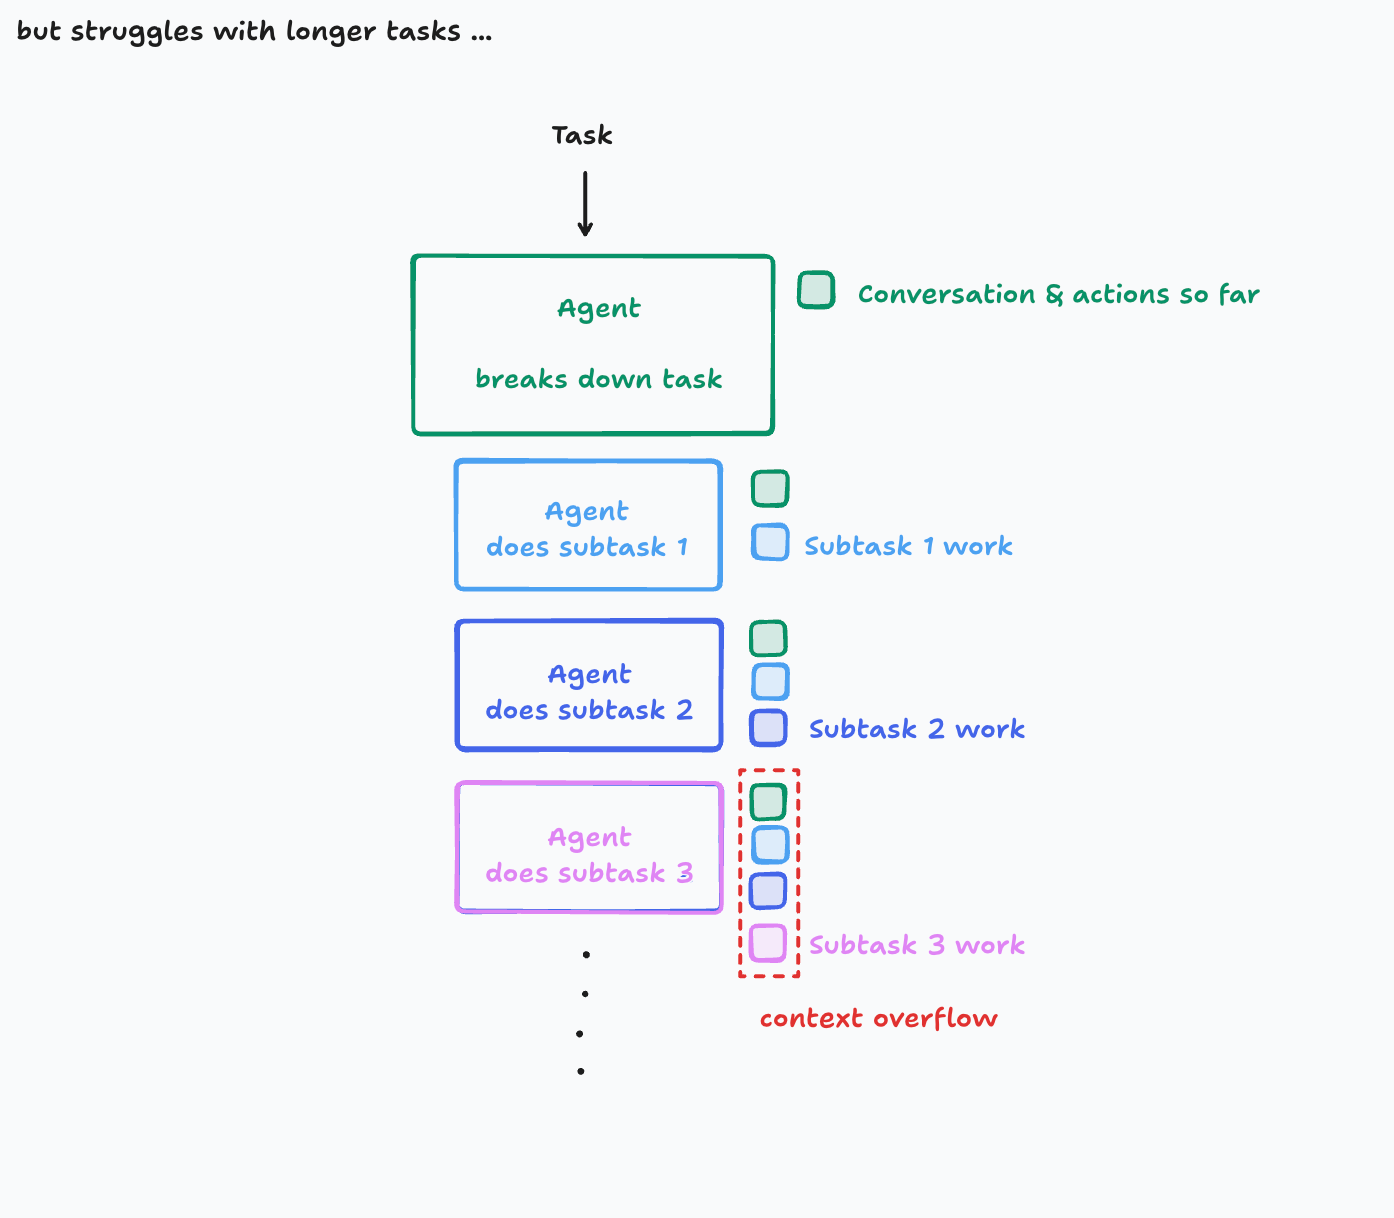
- 限界: この単純なアーキテクチャでは、非常に大きなタスクを扱う際にコンテキストウィンドウのオーバーフローが起きる可能性がある。タスクの進行に伴って、記憶して次へ渡す必要がある情報量が急激に増え、最終的にLLMモデルのコンテキストウィンドウ上限に達する。
- コンテキストウィンドウオーバーフローの模式図:
- コンテキストウィンドウオーバーフローの模式図:
2. 最適化策:「コンテキスト圧縮」の導入
- アーキテクチャ図:
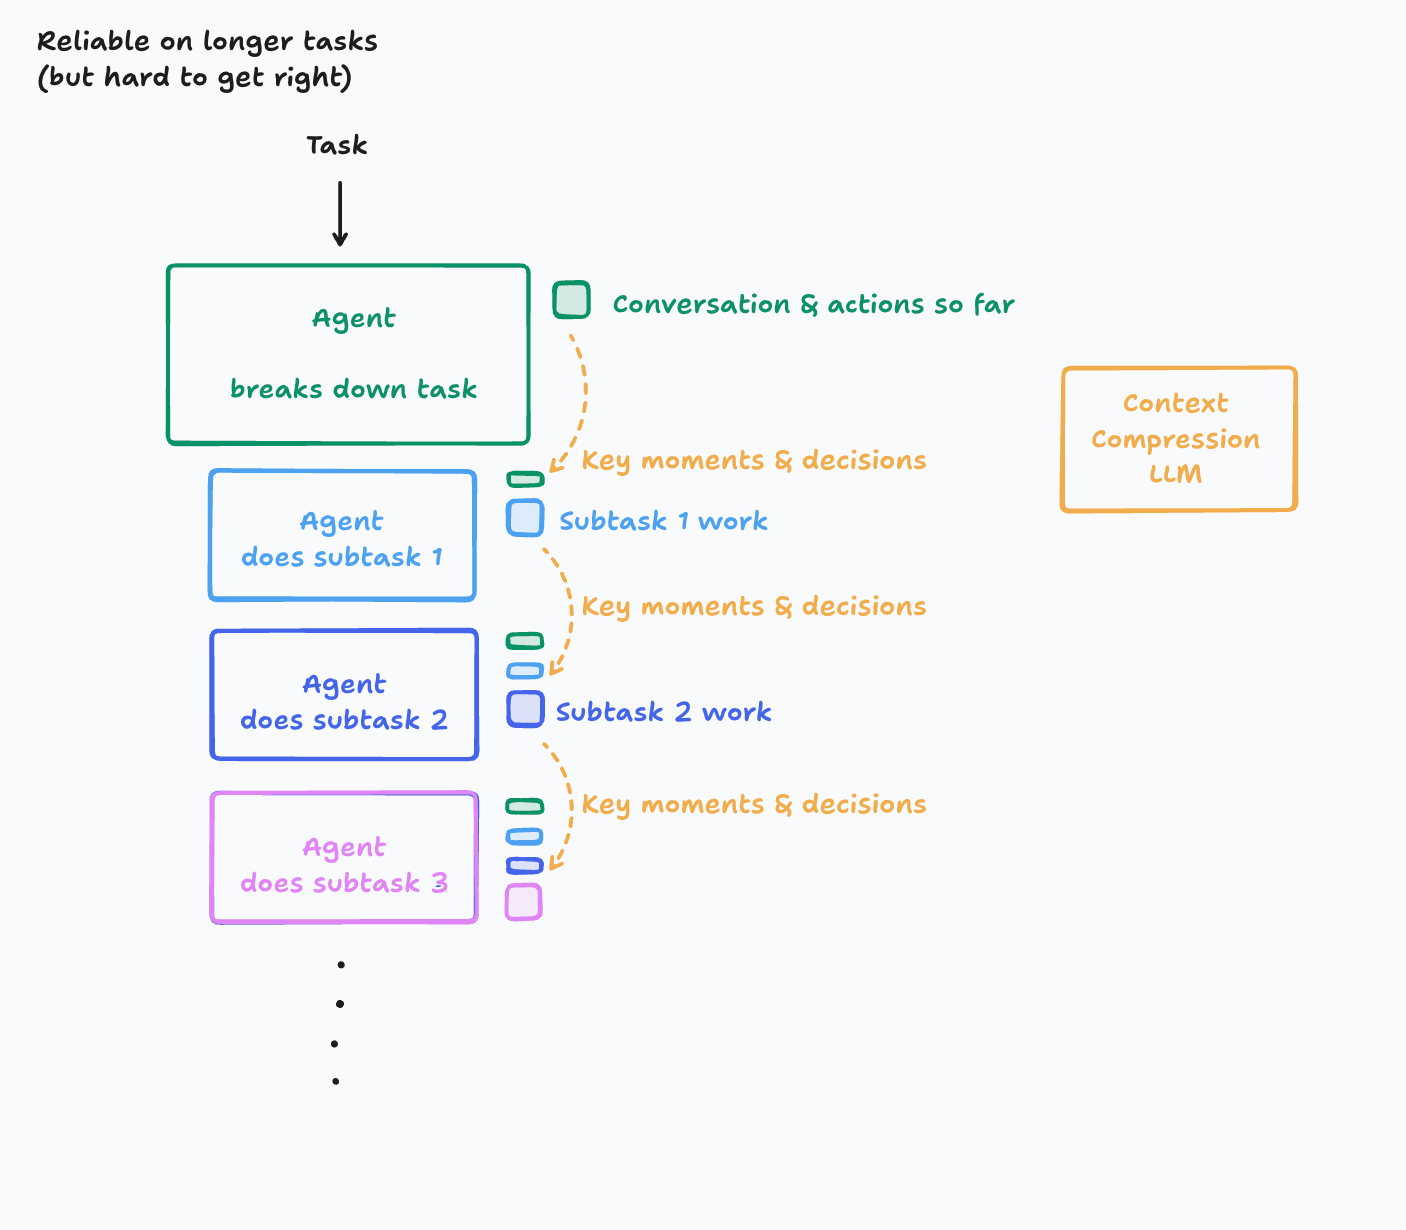
- 中核となる考え方: 本当に長時間動作し、コンテキストが非常に大きくなるタスクでは、新しいLLMモデルを追加し、その主な目的を、これまでのアクションと会話を圧縮して、重要な詳細、重要な出来事、中核となる判断にすることにする。
- 実装上の課題:
- 「重要な情報」を正しく識別して抽出することは非常に困難だ。何が本当に重要かを理解し、この処理を効率よく行えるシステムを設計するには、多大な労力が必要だ。
- 応用分野によっては、コンテキスト圧縮のために小さなモデルをファインチューニングする必要があるかもしれない。Cognitionチームもすでにそうしている。
- 効果: この方法なら、エージェントはより長いコンテキストでも有効に働き続けることができる。
- 限界: コンテキスト圧縮を入れても、いずれも上限に到達する。著者は、任意の長さのコンテキストをどう管理すべきかを考えるよう促している。これはかなり深掘りが必要な領域だ。
三、原則の実践への適用:事例分析
著者は、エージェント開発者は、各行動がシステムのほかの部分で下されたすべての関連判断の背景を十分に把握していることを確認すべきだと指摘している。理想的には「すべての行動からすべてが見える」状態だが、コンテキストウィンドウの制限や現実的なトレードオフがあるため、常に実現できるわけではない。期待する信頼性の水準に応じて、引き受ける複雑さを選定する必要がある。
適用例:
Claude Codeのサブエージェント戦略:
- 現状: 2025年6月時点で、AnthropicのClaude Codeは、サブタスクを生成するエージェントの一例である。
- 重要な設計: サブタスク担当エージェントとは並行して作業しない。また、サブタスク担当エージェントは通常、特定の問いに1つだけ答えるように割り当てられ、コードを一切書かない。
- 理由の分析: サブエージェントにはメインエージェントの完全なコンテキストがないため、範囲が明確に定義された問いを超える複雑な作業(コードを書くなど)を実行できない。複数のサブエージェントを並行して動かすと、互いに衝突する回答を返す可能性があり、前述した『Flappy Bird』の例のように信頼性の問題につながる。
- 利点: この場合、サブエージェントのすべての調査作業(情報の照会など)をメインエージェントの履歴に残す必要がない。そのため、メインエージェントのコンテキスト追跡をより長く保つことができ、コンテキストを早い段階で使い切ることを避けられる。
- 結論: Claude Codeの設計者は、信頼性を確保するために意図的に単純化した方法を選んだ。
「編集適用モデル」の変遷:
- 2024年時点の一般的な手法: 当時は、コード編集でパフォーマンスの低いモデルが多く、コーディングエージェント、IDE、アプリビルダー(Devinを含む)では「編集適用モデル」が広く採用されていた。中核となる考え方は、大型モデルがコード変更をMarkdownで記述した指示(たとえば「関数
fooをbarに変更する」)を出力し、そのMarkdownの指示を小さなモデルに渡して実際にファイルを書き換えさせることだ。この方法は、大型モデルが整形済みのdiffを直接出力させるより信頼性が高いと考えられていた。 - 問題点: これらのシステムには依然としてエラーが多い。小型モデルは、指示中のごくわずかな曖昧さだけでも大型モデルの意図を取り違え、誤った編集を行うことが多い。たとえば、大型モデルが「関数
fooのすべての呼び出しをbarに変更する」と指示しても、小型モデルが1箇所だけを変更してしまうことがある。 - 現在のベストプラクティス: 今では、コード編集の意思決定と実際の適用は、1つのモデルが1つのアクションで完了する方式が優勢になりつつある。これにより、モデル間で情報を渡すときに生じる誤解や曖昧さを避けられるため、信頼性が高まる。
- 2024年時点の一般的な手法: 当時は、コード編集でパフォーマンスの低いモデルが多く、コーディングエージェント、IDE、アプリビルダー(Devinを含む)では「編集適用モデル」が広く採用されていた。中核となる考え方は、大型モデルがコード変更をMarkdownで記述した指示(たとえば「関数