알고리즘과 애니메이션 정리
버블 정렬
버블 정렬(Bubble Sort)은 간단한 정렬 알고리즘으로, 정렬할 목록을 반복해서 순회하며 인접한 원소를 차례로 비교해 순서가 잘못되어 있으면 위치를 교환합니다. 이 과정은 전체 목록에서 더 이상 교환이 필요하지 않을 때까지 반복되고, 최종적으로 정렬된 목록을 얻습니다.
선택 정렬
기본 아이디어는 매번 정렬할 수열에서 가장 작은 원소(또는 가장 큰 원소)를 선택해 수열의 시작 위치에 놓고, 모든 원소가 정렬될 때까지 이 과정을 반복하는 것입니다. javajavajavajavajava
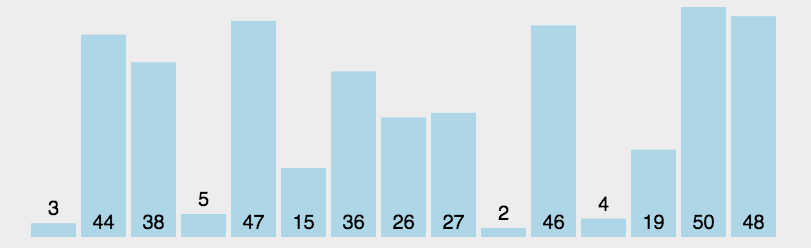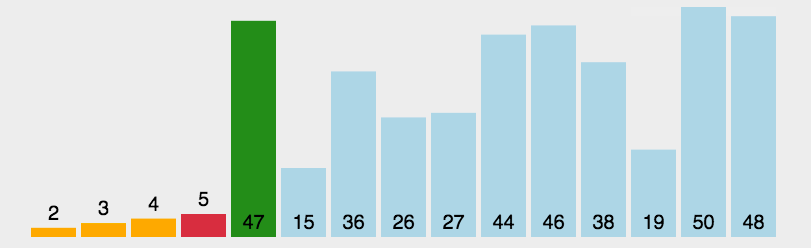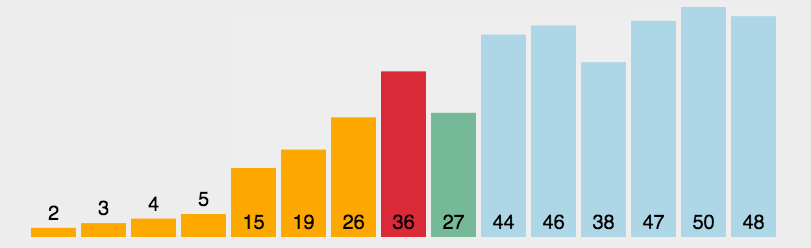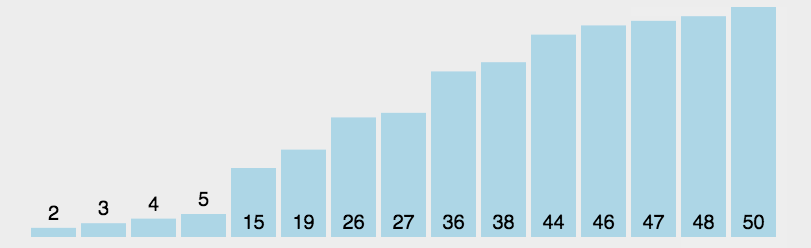
선택 정렬
삽입 정렬
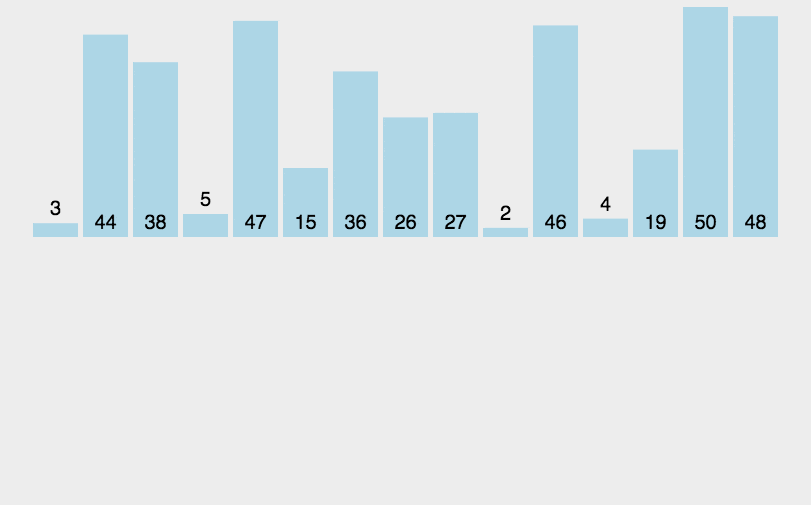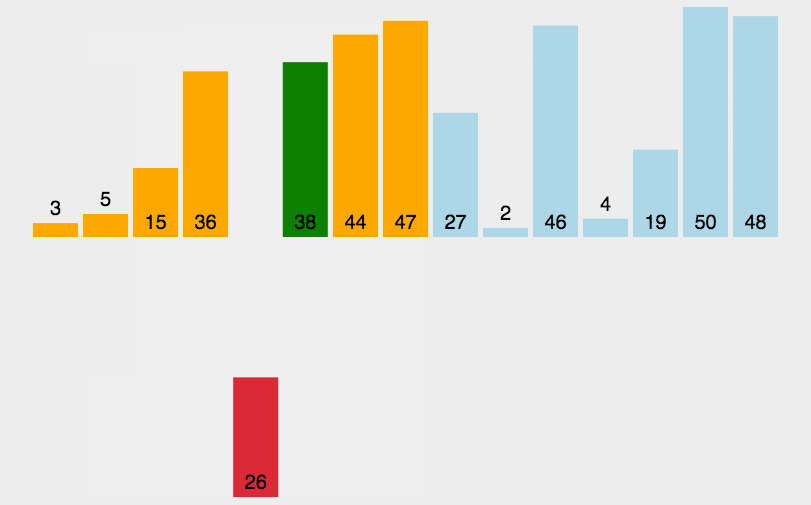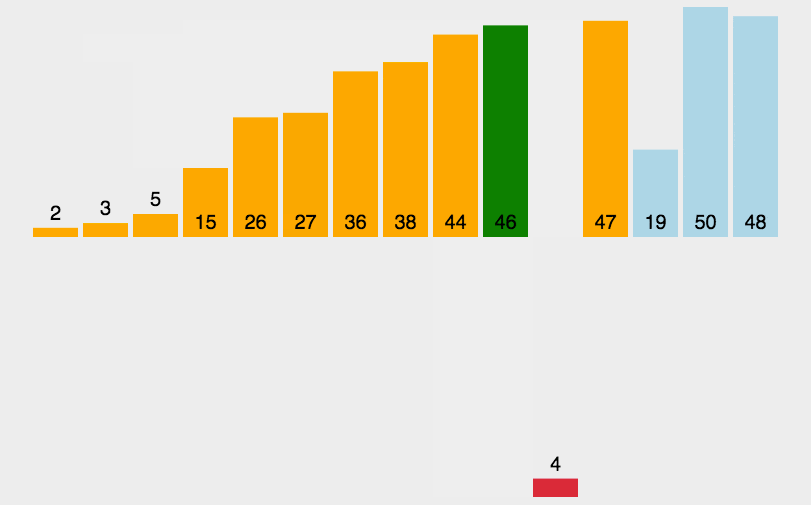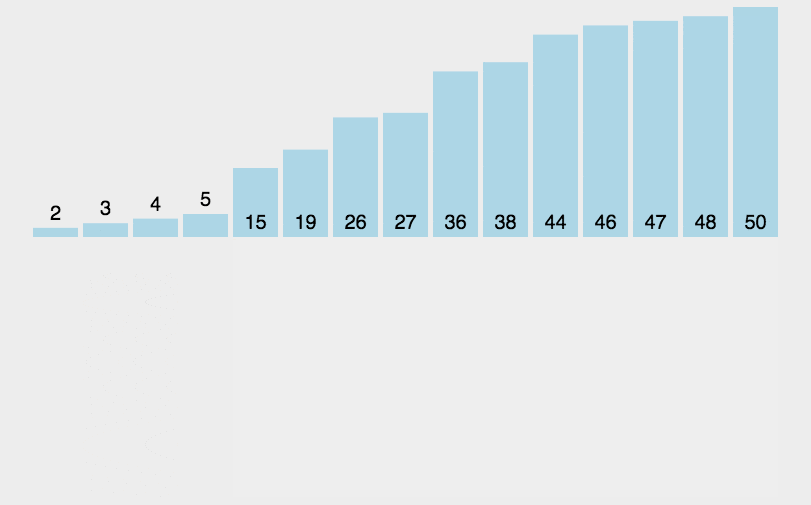
정렬할 수열의 첫 번째 원소를 하나의 정렬된 수열로 보고, 두 번째 원소부터 마지막 원소까지는 정렬되지 않은 수열로 봅니다.
정렬되지 않은 수열을 처음부터 끝까지 순회하며, 만나는 각 원소를 정렬된 수열의 적절한 위치에 삽입합니다. (삽입할 원소가 정렬된 수열의 어떤 원소와 같다면, 삽입할 원소를 같은 값의 원소 바로 뒤에 삽입합니다.)
이미지
퀵 정렬
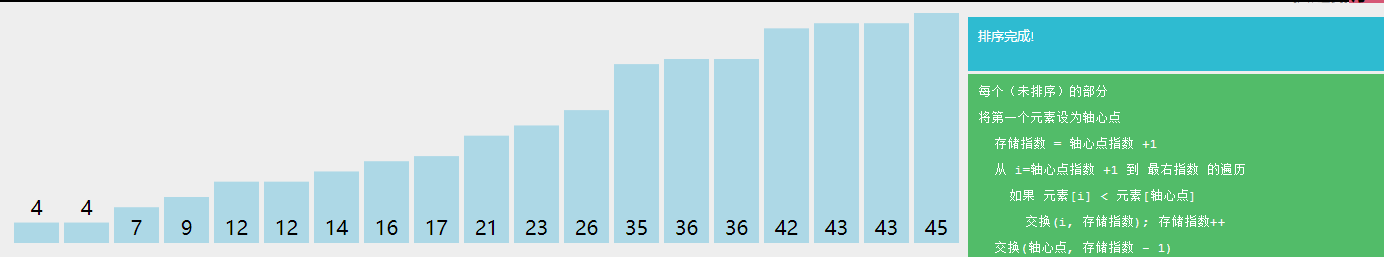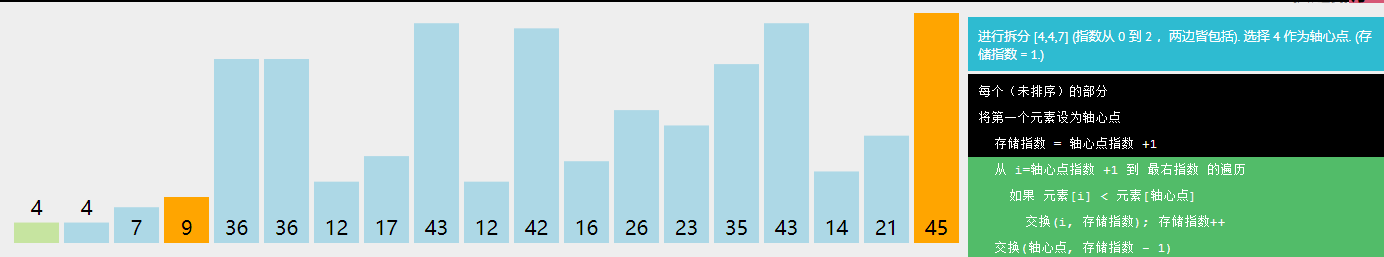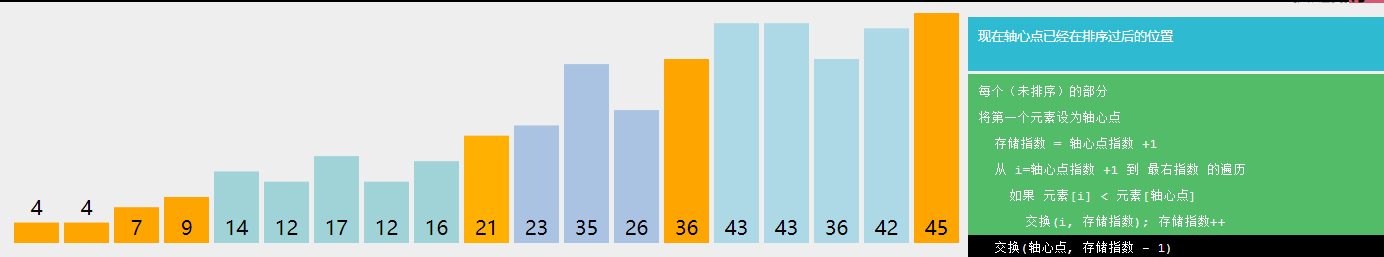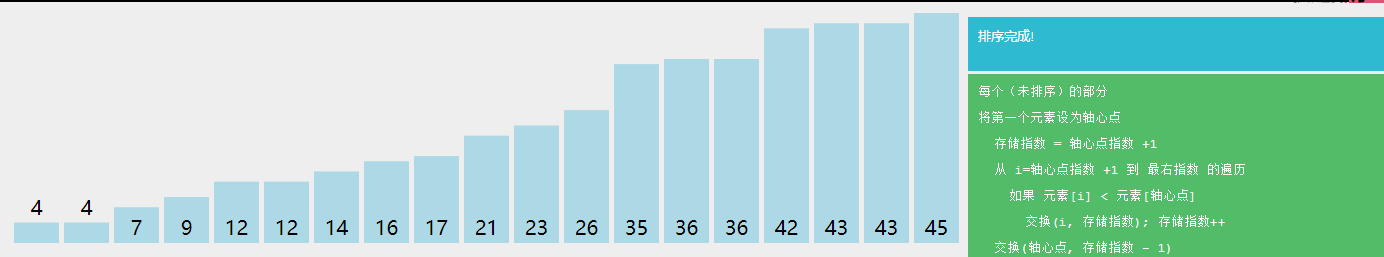
퀵 정렬(QuickSort)은 Tony Hoare가 개발한 효율적인 정렬 알고리즘입니다. 평균적으로 n개 원소를 정렬할 때 Ο(nlogn)번의 비교가 필요하며, 최악의 경우 Ο(n²)번의 비교가 필요할 수 있지만 이러한 경우는 드뭅니다. 사실 퀵 정렬은 내부 루프를 대부분의 하드웨어 아키텍처에서 효율적으로 구현할 수 있기 때문에 일반적으로 다른 Ο(nlogn) 알고리즘보다 빠릅니다.
퀵 정렬은 분할 정복(Divide and Conquer)을 사용해 하나의 수열(list)을 두 개의 하위 수열(sub-lists)로 나누어 정렬합니다. 정렬 알고리즘에 분할 정복을 적용한 고전적인 사례로, 퀵 정렬은 본질적으로 버블 정렬을 기반으로 한 재귀적 분할 정복의 확장입니다.
퀵 정렬의 최악 실행 경우는 O(n²)입니다. 예를 들어 정렬된 수열에 퀵 정렬을 적용하는 경우입니다. 하지만 분할 상환 기대 시간은 O(nlogn)이고, O(nlogn) 표기에 내포된 상수 계수가 매우 작아 복잡도가 안정적으로 O(nlogn)인 병합 정렬보다 훨씬 작습니다. 따라서 순서성이 비교적 약한 대부분의 무작위 수열에서는 퀵 정렬이 항상 병합 정렬보다 우수합니다.
여기에 이미지 설명 삽입
셸 정렬
셸 정렬(Shell Sort)은 감소 증분 정렬 알고리즘이라고도 하며, 삽입 정렬을 효율적으로 개선한 방식이지만 안정 정렬 방식은 아닙니다.
셸 정렬의 개선점은 주로 삽입 정렬의 두 가지 핵심 특성에 기반합니다.
- 삽입 정렬은 거의 정렬된 데이터에서 효율적입니다: 데이터가 거의 정렬되어 있다면 삽입 정렬의 효율이 선형에 가까워질 수 있습니다.
- 삽입 정렬의 한계: 삽입 정렬은 한 번에 원소 하나만 이동할 수 있어 대규모 무순서 데이터를 처리할 때 효율이 낮습니다.
셸 정렬의 기본 아이디어는 다음과 같습니다.
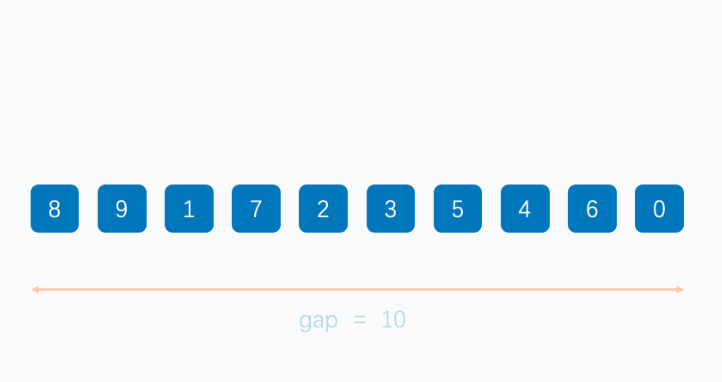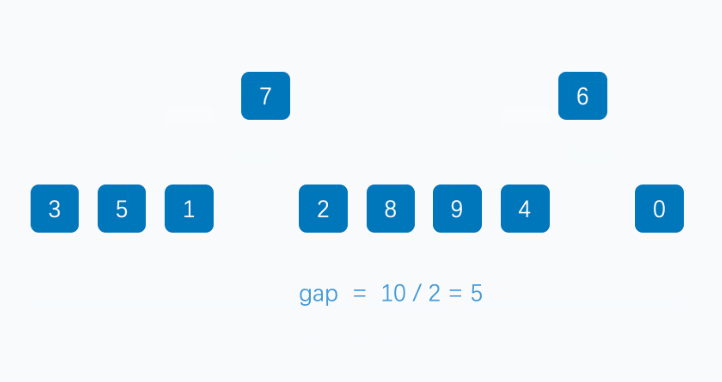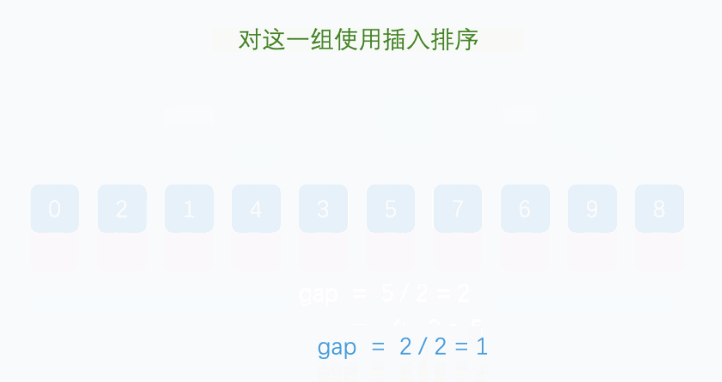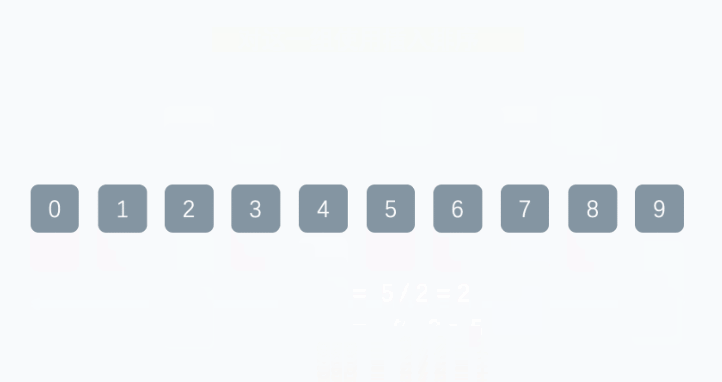
- 그룹별 정렬: 먼저 정렬할 수열을 여러 개의 작은 하위 수열로 나누고 각 하위 수열에 삽입 정렬을 적용합니다. 하위 수열의 그룹은 감소하는 간격(gap)을 사용해 나눕니다. 처음에는 간격이 크고, 정렬이 진행될수록 간격이 점차 줄어듭니다.
- 최종 정렬: 간격이 1까지 줄어들면 전체 수열의 각 원소가 이미 “거의 정렬된 상태”이므로, 전체 원소에 삽입 정렬을 한 번 적용하면 정렬이 완료됩니다.
셸 정렬의 핵심은 합리적인 증분 수열을 선택하는 것입니다. 서로 다른 증분 수열은 정렬 효율에 큰 영향을 주며, 일반적인 증분 수열은 초기에 간격을 n/2로 두고 이후 간격을 1까지 점차 줄이는 방식입니다.
이미지 출처: 인터넷
병합 정렬
병합 정렬(Merge Sort)은 분할 정복을 기반으로 한 효과적인 정렬 알고리즘입니다. 기본 아이디어는 정렬할 수열을 재귀적으로 두 개의 하위 수열로 나누어 각 수열에 원소가 하나만 남을 때까지 나눈 다음, 이 하위 수열들을 점차 하나의 정렬된 수열로 병합하는 것입니다. 병합 정렬은 위에서 아래로 내려가는 재귀적 구현과 아래에서 위로 올라가는 반복적 구현의 두 가지 방식으로 나눌 수 있습니다.
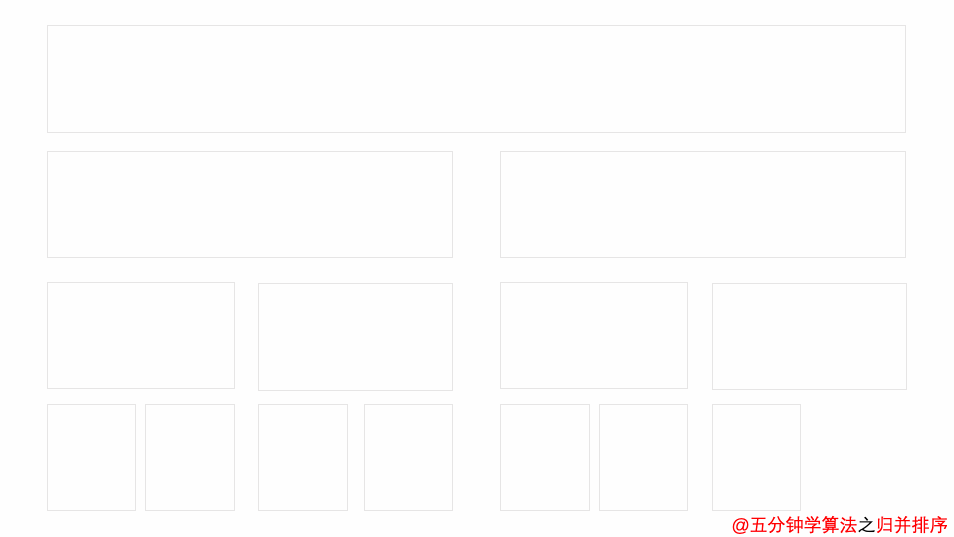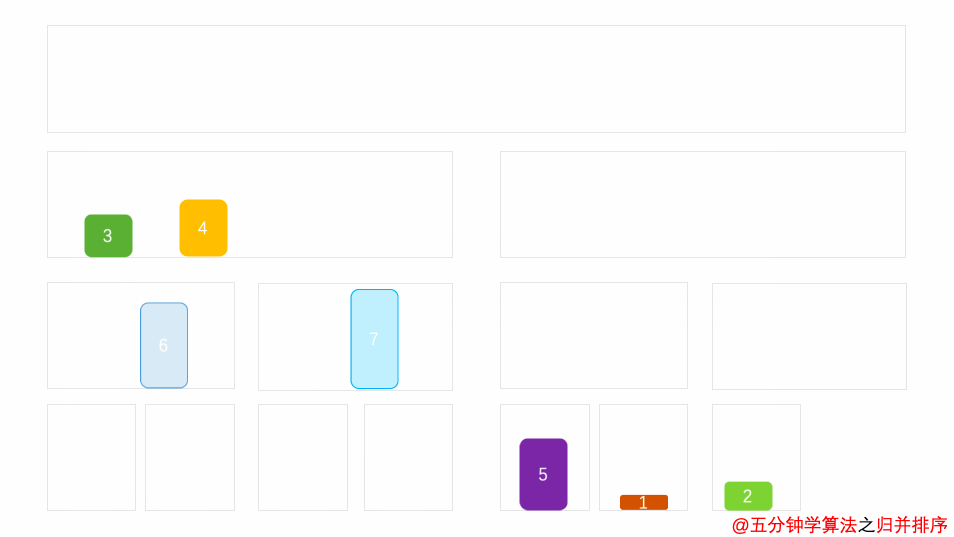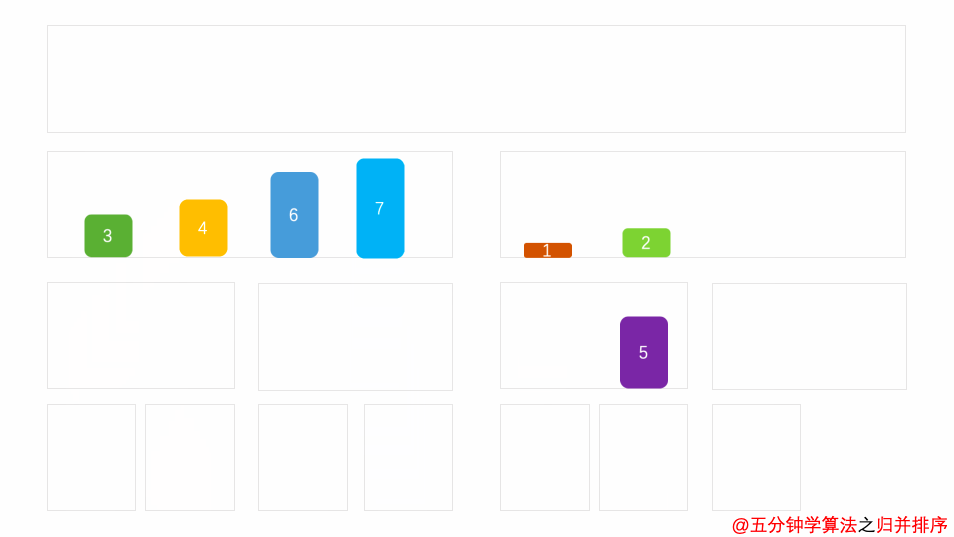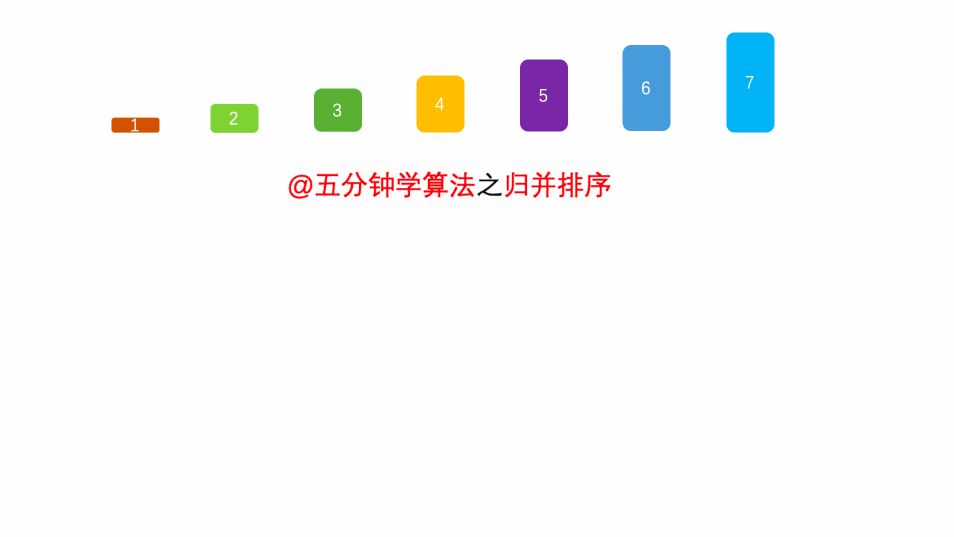
이미지 설명을 추가하세요
힙 정렬
힙 정렬(Heap Sort)은 힙 데이터 구조를 기반으로 한 효과적인 정렬 알고리즘입니다. 힙의 특성을 이용해 정렬을 수행하며, 일반적으로 최대 힙이나 최소 힙을 사용합니다. 힙 정렬의 기본 아이디어는 정렬할 수열을 힙으로 변환한 다음, 힙에서 최댓값 또는 최솟값을 차례로 추출하고 힙 구조를 조정해 정렬을 완성하는 것입니다.
힙 정렬의 기본 단계:
- 힙 구성: 정렬할 배열을 최대 힙(또는 최소 힙)으로 구성합니다. 최대 힙에서는 모든 부모 노드의 값이 자식 노드의 값보다 작지 않습니다. 최소 힙에서는 모든 부모 노드의 값이 자식 노드의 값보다 크지 않습니다.
정렬:
- 힙에서 루트 노드(최댓값 또는 최솟값)를 추출해 힙의 마지막 원소와 교환합니다.
- 힙을 다시 조정해 힙의 특성을 유지합니다.
- 힙이 빌 때까지 위 과정을 반복합니다.
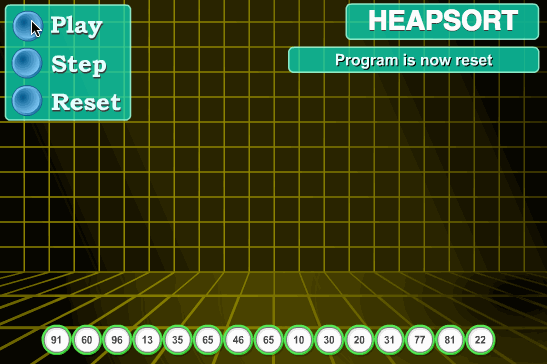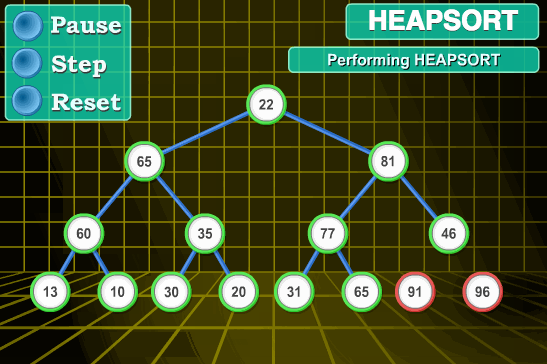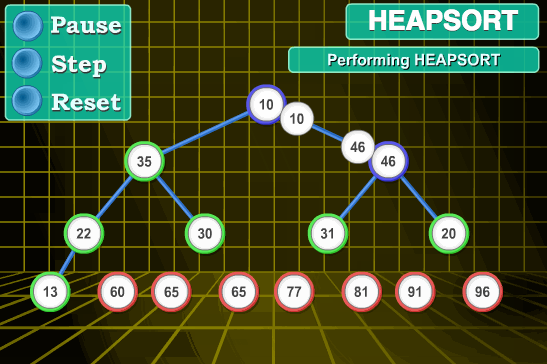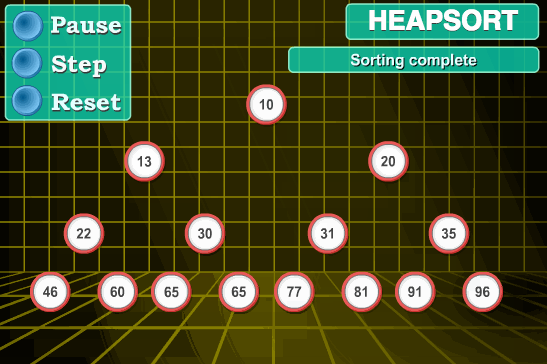
이미지
계수 정렬
계수 정렬은 선형 시간 복잡도를 갖는 정렬 알고리즘으로, 정수의 범위가 제한된 경우에 적합합니다. 기본 아이디어는 각 원소가 나타나는 횟수를 세어 원소의 위치를 결정함으로써 정렬을 완료하는 것입니다. 계수 정렬의 기본 단계는 다음과 같습니다.
- 범위 결정: 먼저 정렬할 원소의 최댓값과 최솟값을 확인합니다. 이 범위가 생성할 카운팅 배열의 크기를 결정합니다.
- 카운팅 배열 생성: 원소의 범위에 맞춰 카운팅 배열을 생성합니다. 배열의 인덱스는 정렬할 원소의 값을, 배열의 값은 해당 값이 나타나는 횟수를 나타냅니다.
- 원소 등장 횟수 집계: 원본 데이터를 순회하면서 각 원소에 해당하는 카운팅 배열 위치의 값을 1 증가시킵니다.
- 누적 카운트 계산: 카운팅 배열의 누적 합을 계산해 각 원소의 최종 위치를 결정합니다.
- 정렬 결과 생성: 누적 카운팅 배열의 정보에 따라 각 원소를 올바른 위치에 넣어 정렬된 배열을 만듭니다.
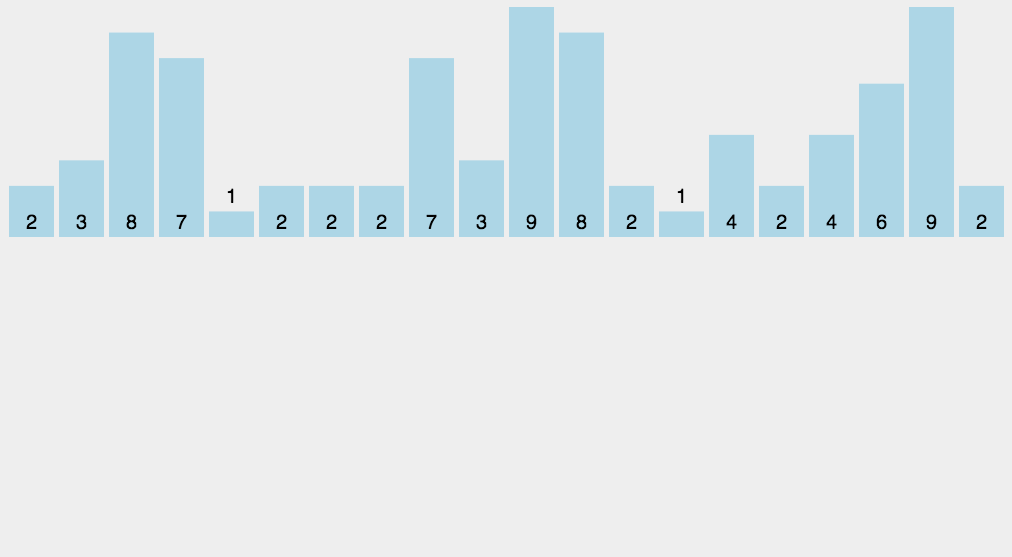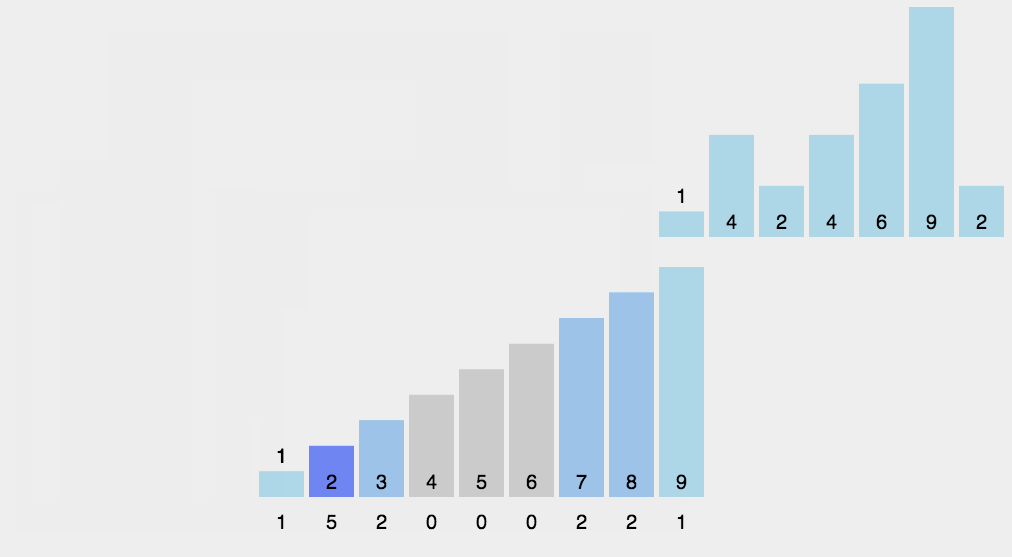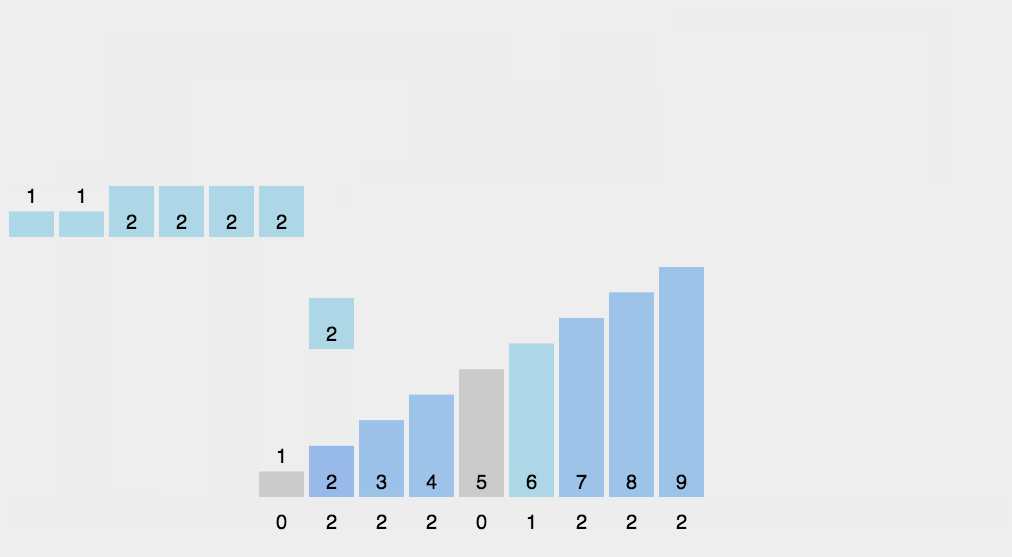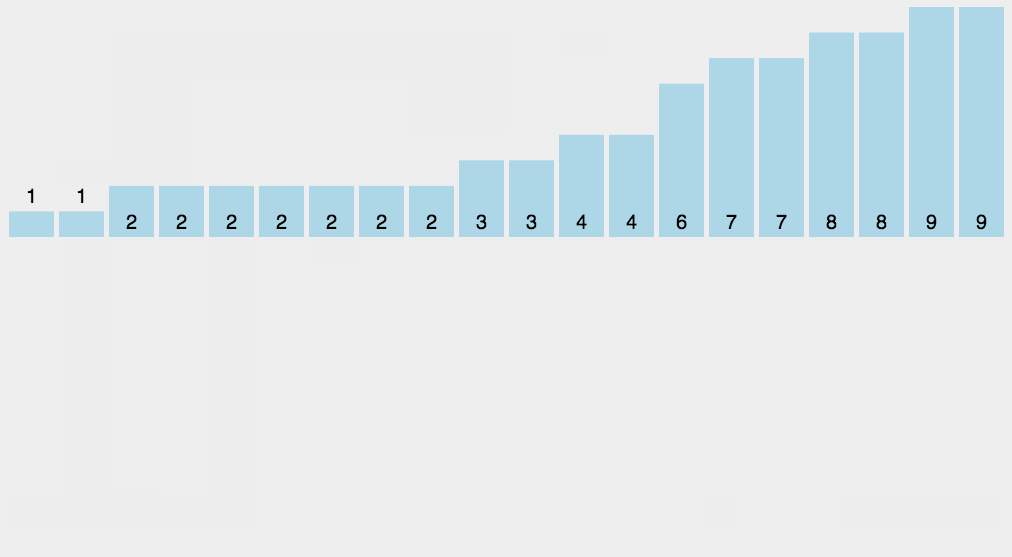
이미지
버킷 정렬
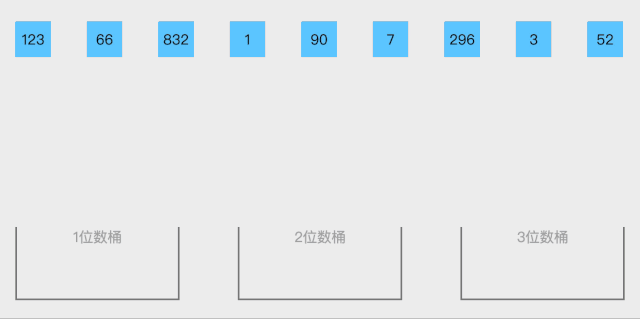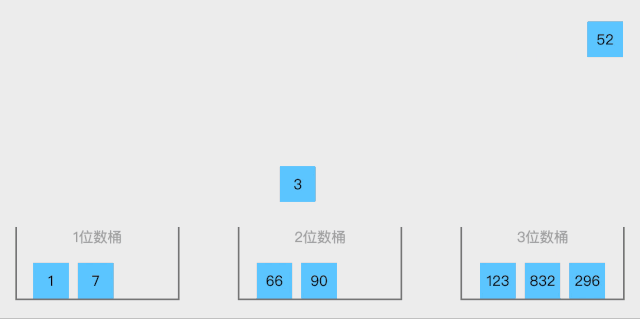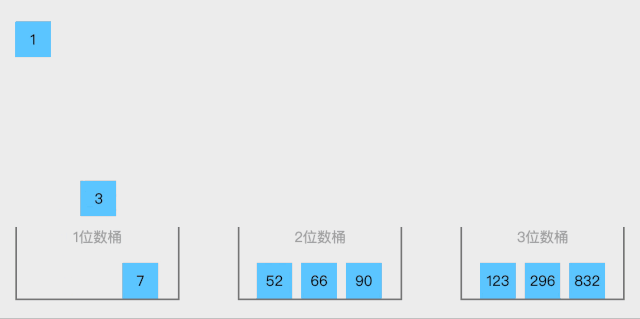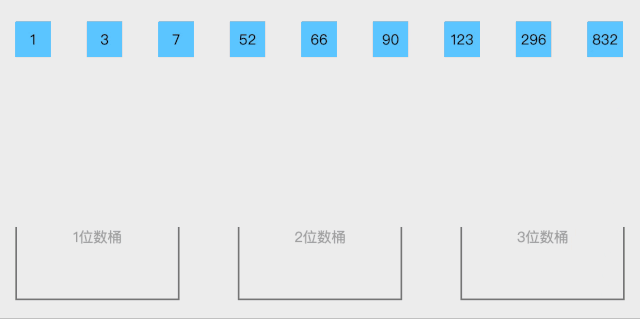
버킷 정렬(Bucket Sort)은 분포를 기반으로 한 정렬 알고리즘으로, 특히 입력 데이터가 균등하게 분포된 경우에 적합합니다. 여러 버킷으로 요소를 나눈 다음 각 버킷 안의 요소를 따로 정렬하고, 마지막으로 모든 버킷의 요소를 순서대로 합쳐 정렬을 완성합니다.
버킷 정렬의 기본 단계
- 버킷 생성: 입력 데이터의 범위와 분포에 따라 일정 개수의 버킷을 생성합니다. 각 버킷은 하나의 구간을 나타냅니다.
- 요소를 버킷에 할당: 입력 배열을 순회하면서 각 요소를 값에 따라 해당 버킷에 넣습니다.
- 각 버킷 내부의 요소 정렬: 삽입 정렬이나 퀵 정렬과 같은 적절한 정렬 알고리즘을 선택해 각 버킷 내부의 요소를 정렬합니다.
- 모든 버킷의 정렬 결과 병합: 각 버킷의 요소를 순서대로 이어 붙여 최종 정렬 배열을 만듭니다.
f9c64c9a4005888a34d6924613556902.gif
기수 정렬
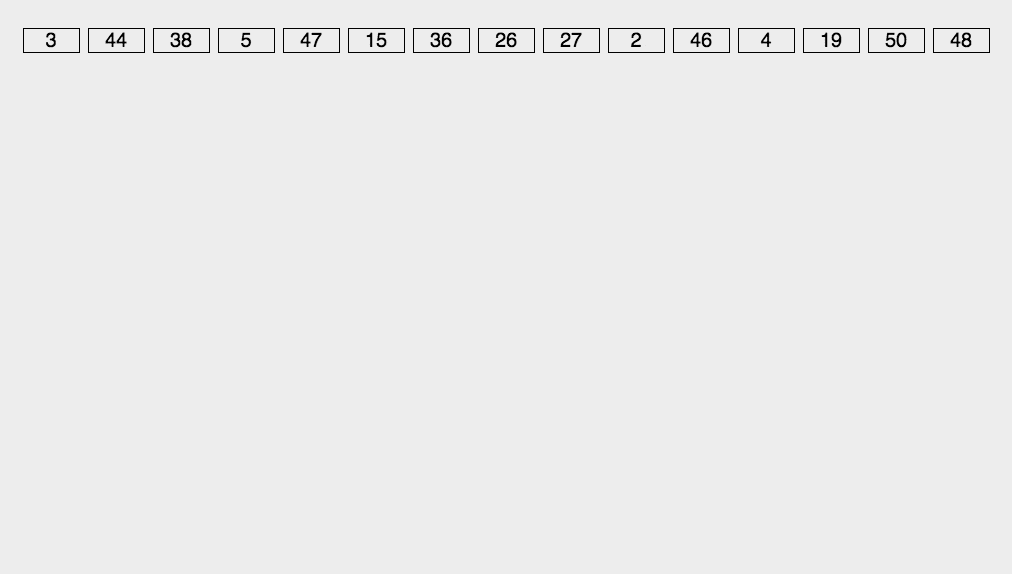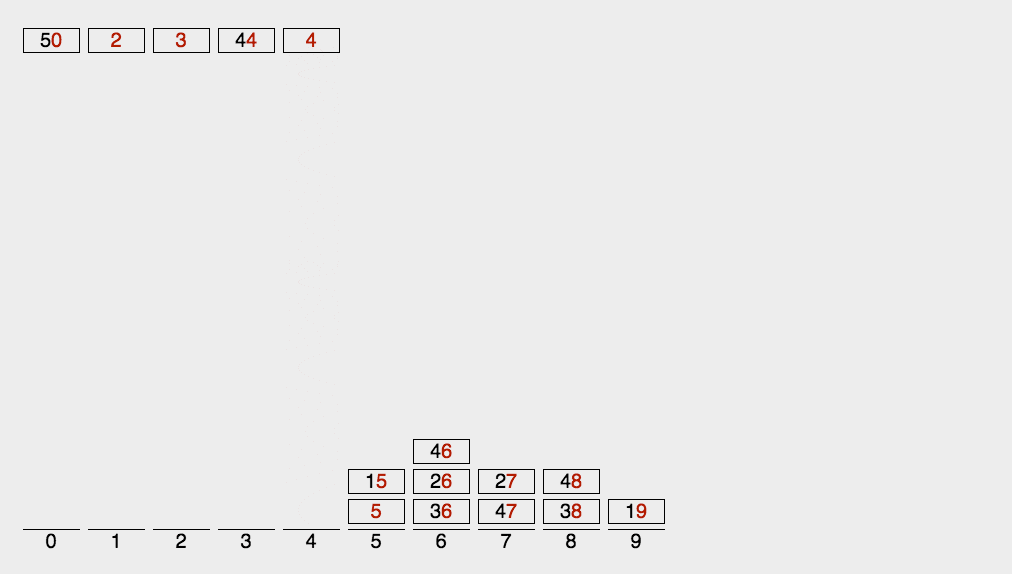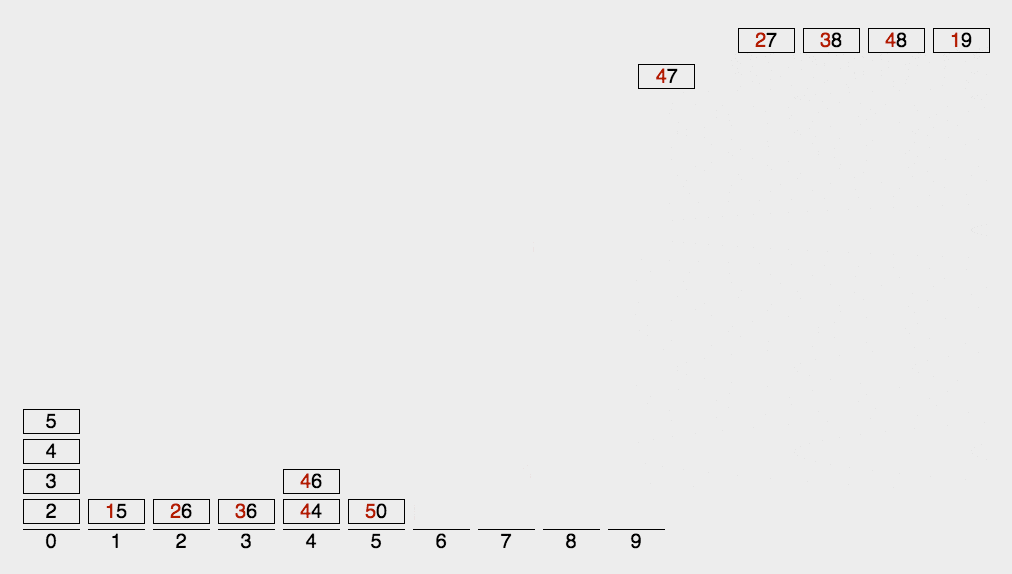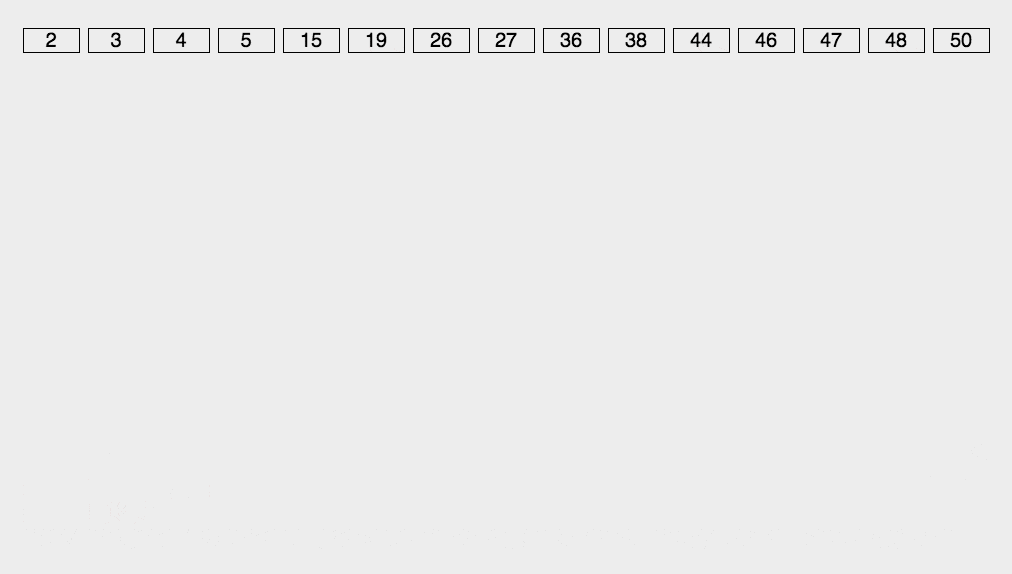
기수 정렬(Radix Sort)은 비교 기반이 아닌 정수 정렬 알고리즘으로, 정수 또는 특정 길이의 문자열을 정렬할 때 적합합니다. 기수 정렬은 각 자리 또는 자릿수에 따라 정렬하며, 가장 낮은 유효 자리(LSD, Least Significant Digit)부터 가장 높은 유효 자리(MSD, Most Significant Digit)까지 여러 차례에 걸쳐 정렬해 최종적으로 배열 전체를 정렬된 상태로 만듭니다.
기수 정렬의 기본 아이디어
기수 정렬의 핵심은 정렬할 숫자를 자리별로(낮은 자리부터 높은 자리까지 또는 그 반대) 정렬하는 것입니다. 기수 정렬은 각 자리의 정렬에 의존하므로 일반적으로 안정 정렬 알고리즘(예: 계수 정렬 또는 버킷 정렬)을 사용합니다. 이를 통해 매 회차 정렬한 뒤에도 해당 자리의 숫자가 같은 원소들이 상대적 순서를 유지합니다.
기수 정렬의 단계
- 최댓값의 자릿수 결정: 배열에서 가장 큰 원소의 자릿수를 찾아 정렬에 필요한 회차 수를 결정합니다.
- 가장 낮은 자리부터 정렬: 가장 낮은 자리부터 각 자리의 숫자를 기준으로 정렬합니다. 이때 계수 정렬 같은 안정 정렬 알고리즘을 사용할 수 있습니다.
- 반복: 더 높은 자리까지 차례대로 정렬을 반복합니다.
- 최종 정렬 결과: 모든 자리의 정렬이 끝나면 배열이 정렬된 상태가 됩니다.
예시
정수 배열 [170, 45, 75, 90, 802, 24, 2, 66]을 기수 정렬한다고 가정해 보겠습니다.
- 최댓값의 자릿수 결정: 최댓값
802는 3자리이므로 정렬은 3라운드로 진행됩니다. 첫 번째 라운드(일의 자리 기준):
- 정렬 결과:
[170, 90, 802, 2, 24, 45, 75, 66]
- 정렬 결과:
두 번째 라운드(십의 자리 기준):
- 정렬 결과:
[802, 2, 24, 45, 66, 170, 75, 90]
- 정렬 결과:
세 번째 라운드(백의 자리 기준):
- 정렬 결과:
[2, 24, 45, 66, 75, 90, 170, 802]
- 정렬 결과:
이미지