1. 연구 배경과 동기
대조 학습은 널리 쓰이는 자기지도 표현 학습 방법으로, 핵심 아이디어는 "유사한 샘플 쌍"(양의 쌍)을 가깝게 붙이고 "서로 다른 샘플 쌍"(음의 쌍)은 멀어지게 밀어내는 것이다arxiv.org. 대표적으로 InfoNCE 손실은 같은 이미지에서 얻은 두 가지 증강 뷰에 유사도 상한을 걸고, 서로 다른 이미지 샘플에는 차이도 하한을 걸도록 한다arxiv.org. InfoNCE와 같은 대조 손실은 이미지 인식 사전학습 등의 과제에서 인상적인 성능을 거두었다arxiv.org. 그러나 한계도 있다. 먼저 모든 샘플에 대해 양의 쌍을 구성하고(보통 데이터 증강으로 얻는다) 대량의 음의 샘플을 관리해야 하므로, 학습 복잡도가 커지고 메모리 소비도 크다arxiv.org. 둘째, 이 방법을 생성 모델(예: 확산 모델)에 직접 적용하면 양의 쌍을 정의하기 어렵다. 확산 모델의 학습 자체가 노이즈 제거 회귀를 목표로 하는데, 여기에 추가적인 뷰 변환을 얹으면 원래의 학습 흐름을 방해하기 쉽다arxiv.org. 실제로 확산 생성 모델은 보통 회귀 손실에만 의존하며, 표현에 대한 명시적인 정규화가 부족하다arxiv.org. 이는 이미지 인식 분야가 표현 학습에重视하는 것과 대비된다arxiv.org.
위와 같은 문제에 대응해 연구자들은 Dispersive Loss(분산 손실)를 제안했다. 이 방법의 동기는 두 가지다. 한쪽으로는, 추가적인 양의 샘플이나 사전학습 모델 없이도 모델 내부의 표현을 풍부하게 만드는 자기지도 정규화를 도입하고 싶었다. 다른 쪽으로는, 확산 모델의 학습 흐름을 "가볍고" "자립적"으로 유지하고 싶었다. 그래서 Dispersive Loss는 내부 특징을 "분산/확산"시키는 정규화 항으로 설계되었다. 즉, 전통적인 대조 손실에서 "서로 다른 샘플을 밀어내는" 역할만 남기고 "같은 샘플을 가까이 당기는" 부분은 버린다arxiv.orgarxiv.org.
2. 방법 소개
Dispersive Loss의 핵심 아이디어는 생성 모델의 중간 특징을 정규화하여, 이들이 표현 공간에서 최대한 "분산"되도록 만드는 것이다. 구체적으로, 한 배치의 입력 샘플과 그에 대응하는 중간 표현 에 대해, 전체 손실 함수는 원래의 회귀 손실 (확산 모델의 노이즈 제거 MSE 등)와 새로 추가한 분산 손실 로 구성된다:
여기서 는 분산 손실의 가중치를 조절한다arxiv.org. Dispersive Loss는 모델의 중간 활성화에 직접 작용하므로, 투영 헤드나 학습 가능한 파라미터를 일절 추가할 필요가 없다arxiv.org. 이러한 설계 덕분에 방법의 자기 정합성이 보장된다. 이면 모델은 원래의 베이스라인으로 퇴화하고, 0이 아닐 때도 기존의 학습 흐름을 바꾸지 않으며, 추가적인 데이터 증강이나 뷰 샘플링이 필요 없다arxiv.org. 즉, Dispersive Loss는 "양의 샘플 없는 대조 손실"인 자기지도 목표라고 볼 수 있다. 회귀 손실 자체가 이미 각 샘플에 정렬된 목표(양의 샘플)를 제공하므로, 밀어내는 역할만 남기면 되는 것이다arxiv.org. InfoNCE를 예로 들면, 원래의 InfoNCE 손실은 다음과 같이 형식화할 수 있다:
여기서 와 는 같은 샘플의 두 뷰 표현이고, 는 유사도(예: 음의 코사인 거리)를 측정하며, 는 온도 계수다arxiv.org. 이 손실에는 양의 샘플을 가까이 당기는 역할(분자 항)과 음의 샘플을 멀리 밀어내는 역할(분모 항)이 함께 들어 있다. Dispersive Loss를 구성할 때 연구자들은 양의 샘플 항을 버리고 밀어내는 부분만 남겼다. 구체적으로, 모든 샘플 표현의 쌍별 거리를 구한 뒤 로그 평균을 취하면 InfoNCE 형태의 분산 손실을 얻는다(논문의 Eq.6):
이 식은 배치 내 임의의 두 샘플 사이 거리를 평균 낸 뒤 부호를 붙여 로그를 취한 것과 동치다arxiv.org. 직관적으로 보면, 이 손실은 모든 샘플 표현 사이의 거리가 커지도록 유도해, 특징 벡터가 공간에 균일하게 분포하도록 만든다("Uniformity" 목표와 유사)arxiv.org. 저자들은 다른 변형도 소개했다. 음의 샘플만 남기는 Hinge 손실이나 Covariance 손실 역시 Dispersive Loss의 实例로 쓸 수 있다arxiv.orgarxiv.org(표 1이 이 변형들을 정리해 준다). 실험 결과 InfoNCE의 거리 형태가 대체로 가장 좋은 성능을 보였다arxiv.org.
원래의 대조 손실과 비교하면, Dispersive Loss에는 몇 가지 뚜렷한 차이가 있다.
- 양의 샘플이나 증강이 필요 없음: 이미지마다 두 번째 뷰를 만들 필요가 없어, 데이터 증강 과정이 생성 모델을 방해하는 문제를 피할 수 있다arxiv.org.
- 가볍고 자립적: 외부 사전학습 모델이나 추가 파라미터에 의존하지 않는다. REPA 같은 표현 정렬 기법과 달리, Dispersive Loss는 전적으로 모델 자신의 내부 표현에 기반한다arxiv.org.
- 목표가 명확함: 샘플 간 "반발"력을 키우는 것만 집중해 특징을 분산시키고arxiv.orgarxiv.org, 양의 예시 사이의 정렬은 회귀 손실이 자동으로 맡도록 남겨 둔다.
3. 실험 설계와 결과
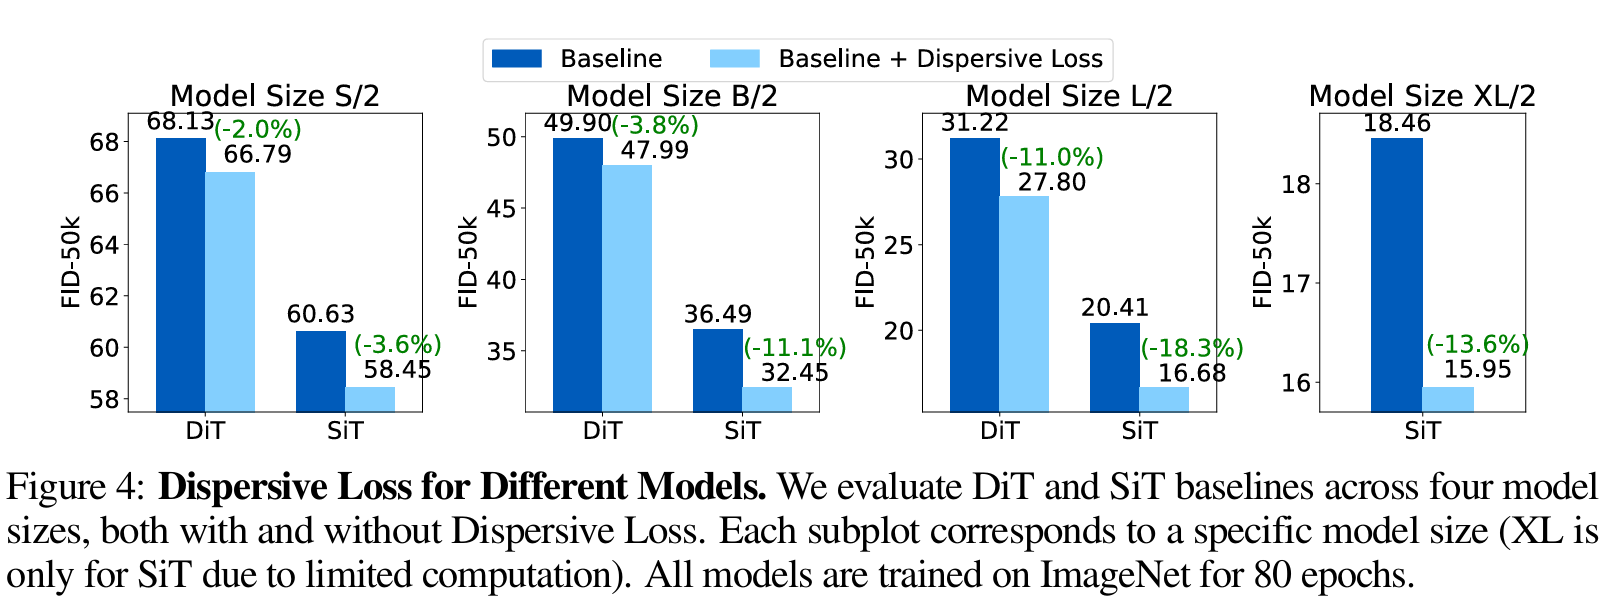
저자들은 ImageNet-1K(256×256) 데이터셋에서 여러 확산 생성 모델을 검증했다. 여기에는 서로 다른 규모의 SiT(Score Distillation Transformer)와 DiT 모델이 포함된다arxiv.orgarxiv.org. 베이스라인 모델은 표준 확산 회귀 손실만 사용하고, 여기에 Dispersive Loss를 더한 모델과 비교했다. 평가 지표는 FID-50k(ImageNet에서 널리 쓰이는 이미지 품질 지표)다.
- 전반적인 개선: 실험 결과, Dispersive Loss를 추가하자 모든 모델에서 품질이 개선되었다. 예를 들어 SiT-B/2 모델(80 epoch 학습)에서는 베이스라인 FID가 36.49였지만 Dispersive Loss를 더하면 32.35로 떨어졌다(상대적으로 11.35% 감소)arxiv.org. 더 큰 SiT-XL/2 모델에서는 80 epoch 학습이 끝났을 때 가이드 없는 FID가 18.46에서 15.95로 내려갔고(13.6% 감소), classifier-free 가이드를 도입해도 유사한 개선이 나타났다(6.02→5.09, -15.4%)arxiv.org. 이러한 개선은 모델 규모(S/B/L/XL)와 학습 epoch 수에 관계없이 일관되게 나타났다arxiv.orgarxiv.org.
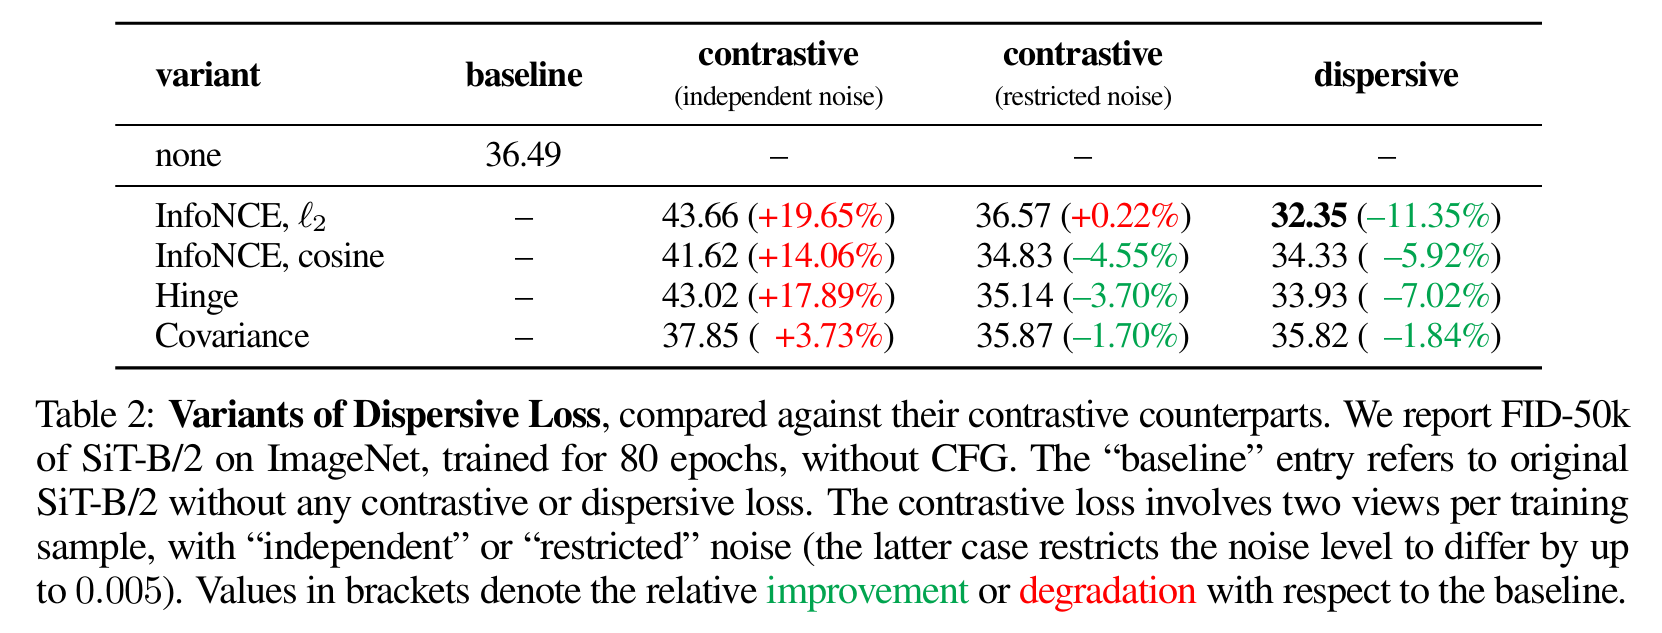
- 절제 실험: 저자들은 서로 다른 변형과 하이퍼파라미터를 분석했다. InfoNCE(거리 기반 또는 코사인 기반), Hinge, Covariance 등 여러 형태의 Dispersive Loss를 비교했고(표 2), 모든 변형이 정규화를 쓰지 않은 베이스라인보다 우수했으며 InfoNCE 거리 형태가 가장 좋았다arxiv.org. 또한 Dispersive Loss를 네트워크의 서로 다른 계층(Transformer의 block)에 적용해도 모두 FID가 낮아졌다(표 3). 모든 층에 정규화를 넣었을 때 이득이 가장 컸다arxiv.org. 정규화 가중치 와 온도 의 선택은 결과에 큰 영향을 주지 않았고, 비교적 넓은 구간에서 모두 베이스라인을 뚜렷하게 앞섰다arxiv.org.
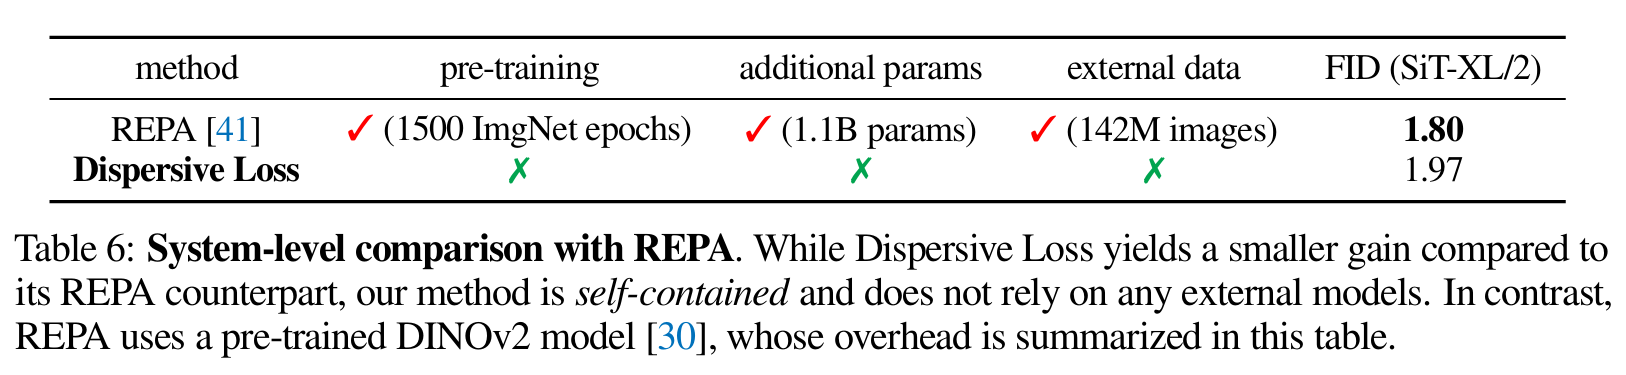
- 다른 기법과의 비교: Dispersive Loss는 REPA 같은 기법과도 비교했다. REPA는 표현을 정렬하기 위해 외부 사전학습 모델(예: 파라미터 1.1B의 DINOv2)에 의존하지만, Dispersive Loss는 완전히 자립적이어서 추가 데이터가 필요 없다. 구체적으로 SiT-XL/2 실험에서 Dispersive Loss의 FID는 1.97, REPA가 보고한 수치는 1.80이었다arxiv.org. 후자가 조금 더 낮지만, Dispersive Loss는 외부 모델이나 데이터를 전혀 쓰지 않는다는 점을 감안하면 가성비가 더 높다arxiv.orgarxiv.org.
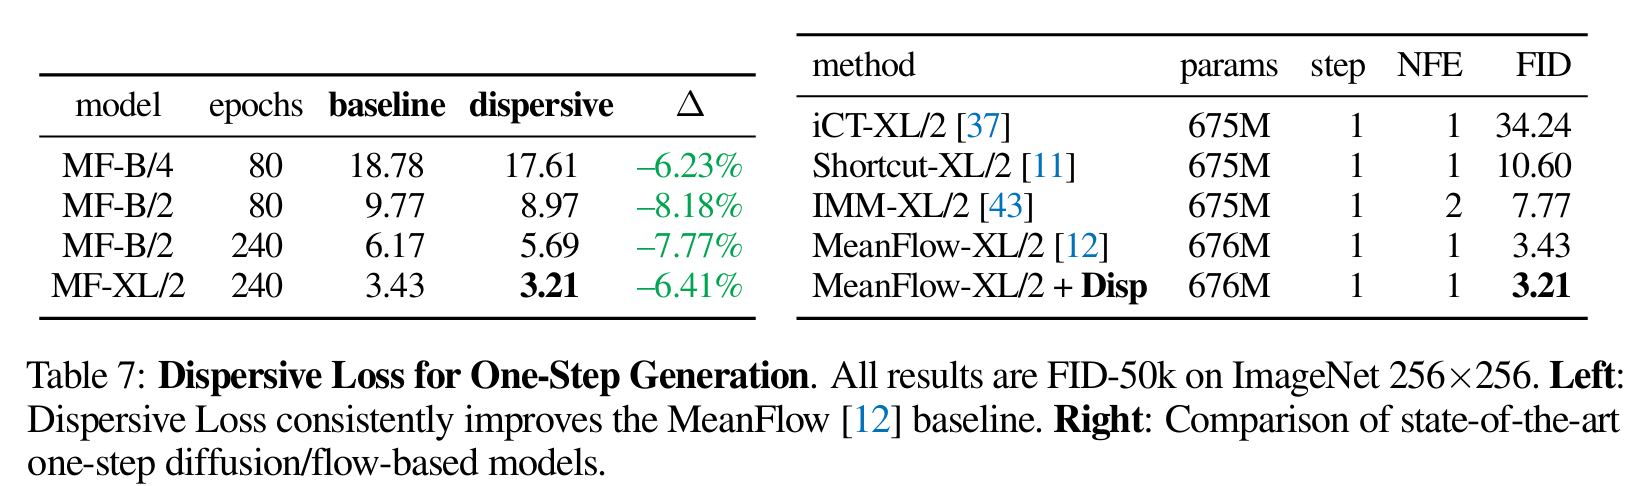
- 단일 단계 생성 테스트: 저자들은 최신 단일 단계 확산 프레임워크인 MeanFlow에도 Dispersive Loss를 적용했다. 실험 결과(표 7)에 따르면 MeanFlow-XL/2 모델에 Dispersive Loss를 추가하자 FID가 3.43에서 3.21로 더 낮아져, 단일 단계 생성의 최고 수준을 새로 establishes했다arxiv.org. 이는 이 방법이 다단계 모델에만 머무는 것이 아니라 단일 단계 생성의 품질도 끌어올릴 수 있음을 보여준다.
전체적으로, 각 실험은 Dispersive Loss의 효과를 일관되게 검증했다. 데이터셋, 모델 규모, 학습 조건이 달라질 때마다 생성 품질이 눈에 띄게 개선되었고(FID 10% 이상 감소), 전통적인 대조 손실을 그냥 더하는 것은 오히려 성능 저하를 초래할 수 있었다arxiv.orgarxiv.org.
4. 의미와 영향
Dispersive Loss는 표현 학습과 자기지도 학습 분야에 새로운 관점과 기여를带来了. 먼저, "양의 샘플 없는" 대조 학습 프레임워크를 제안해 음의 샘플(또는 그에 상응하는 형태)만을 활용한 학습을 강조했다arxiv.orgarxiv.org. 이는LOL 기존 연구에서는 드문 시도다. 기존 작업들은 "음의 샘플 없는" 대조 학습(如 BYOL)에关注的 반면, Dispersive Loss는 "양의 샘플 없는" 대조 학습이라는 방향을 열었다arxiv.org. 이론적으로 보면, 이는 전통적인 InfoNCE의 정렬(alignment) 부분을 다른 목표에 맡기고 균일성(uniformity)의 정규화 항만 남기는 것과 같아, 표현 학습에서 정렬과 균일성 사이의 트레이드오프를 이해하는 새로운 관점을 제공한다.
둘째, 응용 측면에서 Dispersive Loss는 자기지도 정규화가 생성 모델 품질을 크게 끌어올릴 수 있음을 보여줬고, 그 구현 방식은 놀라울 정도로 단순하다. 추가 데이터나 사전학습, 복잡한 아키텍처 없이, 학습 과정에 "특징을 흩뿌리는" 손실 항 하나만 덧붙이면 된다arxiv.orgarxiv.org. 이러한 자기 정합적이고 가벼운 설계 덕분에 기존 생성 모델의 학습 파이프라인에 쉽게 통합할 수 있다. 대규모 모델 학습에서 이러한 정규화는 특히 중요하다. 저자들은 더 강한 파운데이션 모델(더 큰 Transformer)이 Dispersive Loss에서 더 큰 이득을 얻는다는 점을 관찰했다arxiv.org. 이는 이 방법이 추가 정규화 항으로서 과적합을 실제로 방지한다는 것을 시사한다. 실무적으로는 Stable Diffusion, DALLE 같은 대형 생성 모델을 학습할 때도 유사한 분산 정규화 방식이 생성 품질을 개선할 수 있을 것으로 기대된다.
마지막으로, 이 작업은 더 거시적인 관점에서 생성 모델과 표현 학습의 융합을 촉진했다. 저자들은 Dispersive Loss로 "생성 모델링과 표현 학습 사이의 간극"을 좁히고 싶어 한다arxiv.org. 구체적으로, 자기지도 학습의 사상을 생성 과제로 끌어왔고, 생성 모델 내부에 다양화된 표현을 학습할 명시적 메커니즘을 제공한다. 동시에 이 방법의 보편성(다양한 모델과 과제에 적용 가능)은 다른 시사점도 준다. 사전 정의된 양의 쌍에 의존하지 않는 과제, 예를 들어 자연어 생성이나 강화학습의 특징 표현 같은 영역에서도 이와 유사한 정규화 설계를 시도해 볼 수 있다는 것이다.
요약: Dispersive Loss는 대조 학습의 "밀어내기" 메커니즘을 떼어 내 단독으로 적용함으로써, 새롭고 사용하기 쉬운 표현 학습 손실을 제안했다. 이 방법은 이미지 생성 과제에서 뚜렷한 향상을 거두며 효과를 검증했고, 동시에 그 간결함과 자립성 덕분에 잠재적으로 널리 적용될 수 있어 자기지도 학습과 생성 모델 연구에 새로운 방향을 열었다arxiv.orgarxiv.org.