원문 링크: 인지 | 다중 에이전트를 만들지 마세요 --- Cognition | Don’t Build Multi-Agents
핵심 아이디어와 저자의 관점
저자는 현재 LLM(대형 언어 모델) 기반 에이전트 프레임워크의 실제 성능이 기대에 미치지 못한다고 지적합니다. 특히 여러 에이전트의 협업을 중시하는 ‘다중 에이전트’ 구조에서 그 문제가 두드러집니다. 자신의 팀에서 얻은 시행착오 경험을 바탕으로 신뢰할 수 있고 장시간 실행 가능한 에이전트를 구축하기 위한 핵심 원칙을 제시합니다. 또한 겉보기에는 매력적인 다중 에이전트 아키텍처가 현실에서 어떻게 이 원칙을 어기게 되는지, 그래서 왜 취약하고 신뢰할 수 없는 시스템으로 이어지는지를 깊이 설명합니다.
1. 컨텍스트 엔지니어링 원칙: 신뢰할 수 있는 에이전트의 토대
저자는 LLM과 AI 에이전트의 시대를 탐색 단계로 봅니다. 이는 웹의 초기 개발자들이 HTML과 CSS를 더듬던 때와 비슷합니다. ‘컨텍스트 엔지니어링’은 효율적이고 신뢰할 수 있는 에이전트를 구축하는 핵심이며, 전통적인 ‘프롬프트 엔지니어링’보다 한 단계 더 나아가 동적 시스템에서 모델에 필요한 정확한 컨텍스트를 자동으로 관리하고 제공한다는 점을 강조합니다.
에이전트 구축의 두 가지 핵심 원칙:
공유 컨텍스트(Share Context):
- 원리: 에이전트는 고립된 메시지나 현재 지시만 받는 것이 아니라, 전체 ‘대화 기록’과 ‘의사 결정 경로’를 살펴보고 이해해야 합니다. 즉, 개별 메시지뿐 아니라 전체 에이전트 추적 기록(full agent traces)을 공유해야 합니다.
- 중요성: LLM 모델은 지능적이더라도 충분한 컨텍스트가 없으면 효과적으로 일할 수 없습니다. 사람이 일을 수행할 때 전제와 결과, 경위와 맥락을 파악해야 하는 것처럼, 에이전트도 작업을 오해하거나 일관되지 않은 결정을 내리지 않도록 하는 데 이 정보가 필요합니다.
- 반례(다중 에이전트 분업 구조의 취약성):
- 아키텍처 다이어그램:
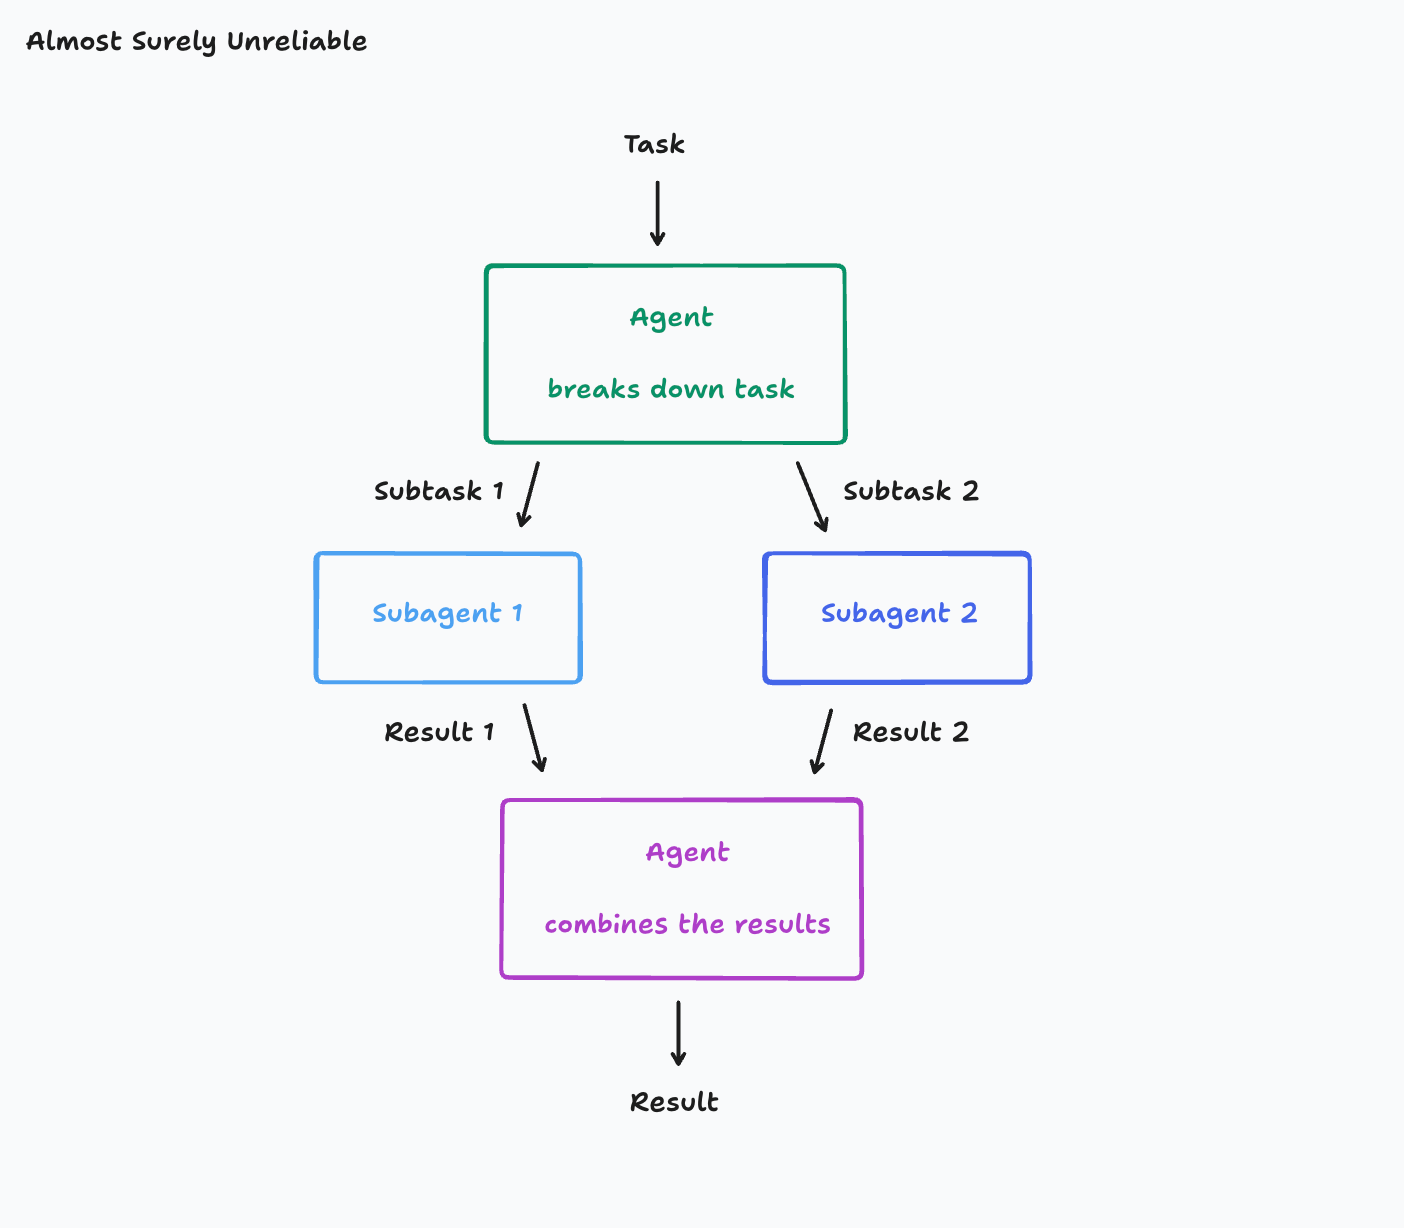
- 예시 분석: 작업(Task)이 ‘《Flappy Bird》 클론 만들기’라고 가정해 봅시다. 이 작업은 하위 작업 1인 ‘초록색 파이프와 충돌 박스가 있는 움직이는 게임 배경 만들기’와 하위 작업 2인 ‘위아래로 움직일 수 있는 작은 새 만들기’로 분해됩니다.
- 문제점: 하위 에이전트(Subagent)가 자신에게 배정된 하위 작업 지시만 받고, 원래의 전체 작업 설명과 메인 에이전트(Main Agent)가 작업을 분해하면서 내린 모든 결정과 고려 사항을 볼 수 없다면 ‘오해’가 쉽게 발생합니다:
- 하위 에이전트 1은 ‘배경’의 스타일을 잘못 이해해 《슈퍼 마리오 브라더스》처럼 보이는 배경을 만들기 시작할 수 있습니다.
- 하위 에이전트 2가 만든 새는 게임 에셋답지 않아 보일 수 있고, 이동 방식이 《Flappy Bird》의 메커니즘과 완전히 다를 수도 있습니다.
- 결과: 결국 메인 에이전트는 ‘오해’에서 나온 두 결과물, 즉 서로 어긋난 배경과 요구 사항에 맞지 않는 새를 조합해야 하는 어려운 일을 떠안게 됩니다.
- 근본적인 이유: 현실 세계의 작업에는 여러 층위의 미묘한 차이가 많습니다. 여러 차례의 대화 과정에서 에이전트는 작업을 어떻게 분해할지 결정하기 위해 여러 번 도구를 호출해야 할 수 있으며, 그 세부 사항 하나하나가 하위 작업의 해석에 큰 영향을 줄 수 있습니다. 하위 에이전트가 이 전체 이력에 접근하지 못하면 결과가 서로 어긋나기 쉽습니다.
- 아키텍처 다이어그램:
행동에는 암묵적 결정이 따릅니다(Actions Carry Implicit Decisions):
- 원리: 에이전트의 모든 행동에는 현재 컨텍스트를 바탕으로 내린 암묵적 결정이 포함됩니다. 이 암묵적 결정들이 서로 충돌하는 가정에 기반한다면 최종 결과는 좋을 수 없습니다.
- 중요성: 에이전트의 행동은 지시문을 실행하기만 하는 것이 아니라, 에이전트가 작업을 이해한 방식과 내부의 ‘사고’ 과정을 반영합니다. 이러한 암묵적 결정들은 일관성을 유지해야 합니다.
- 반례(다중 에이전트 병렬 작업에서 발생하는 불일치):
- 아키텍처 다이어그램:
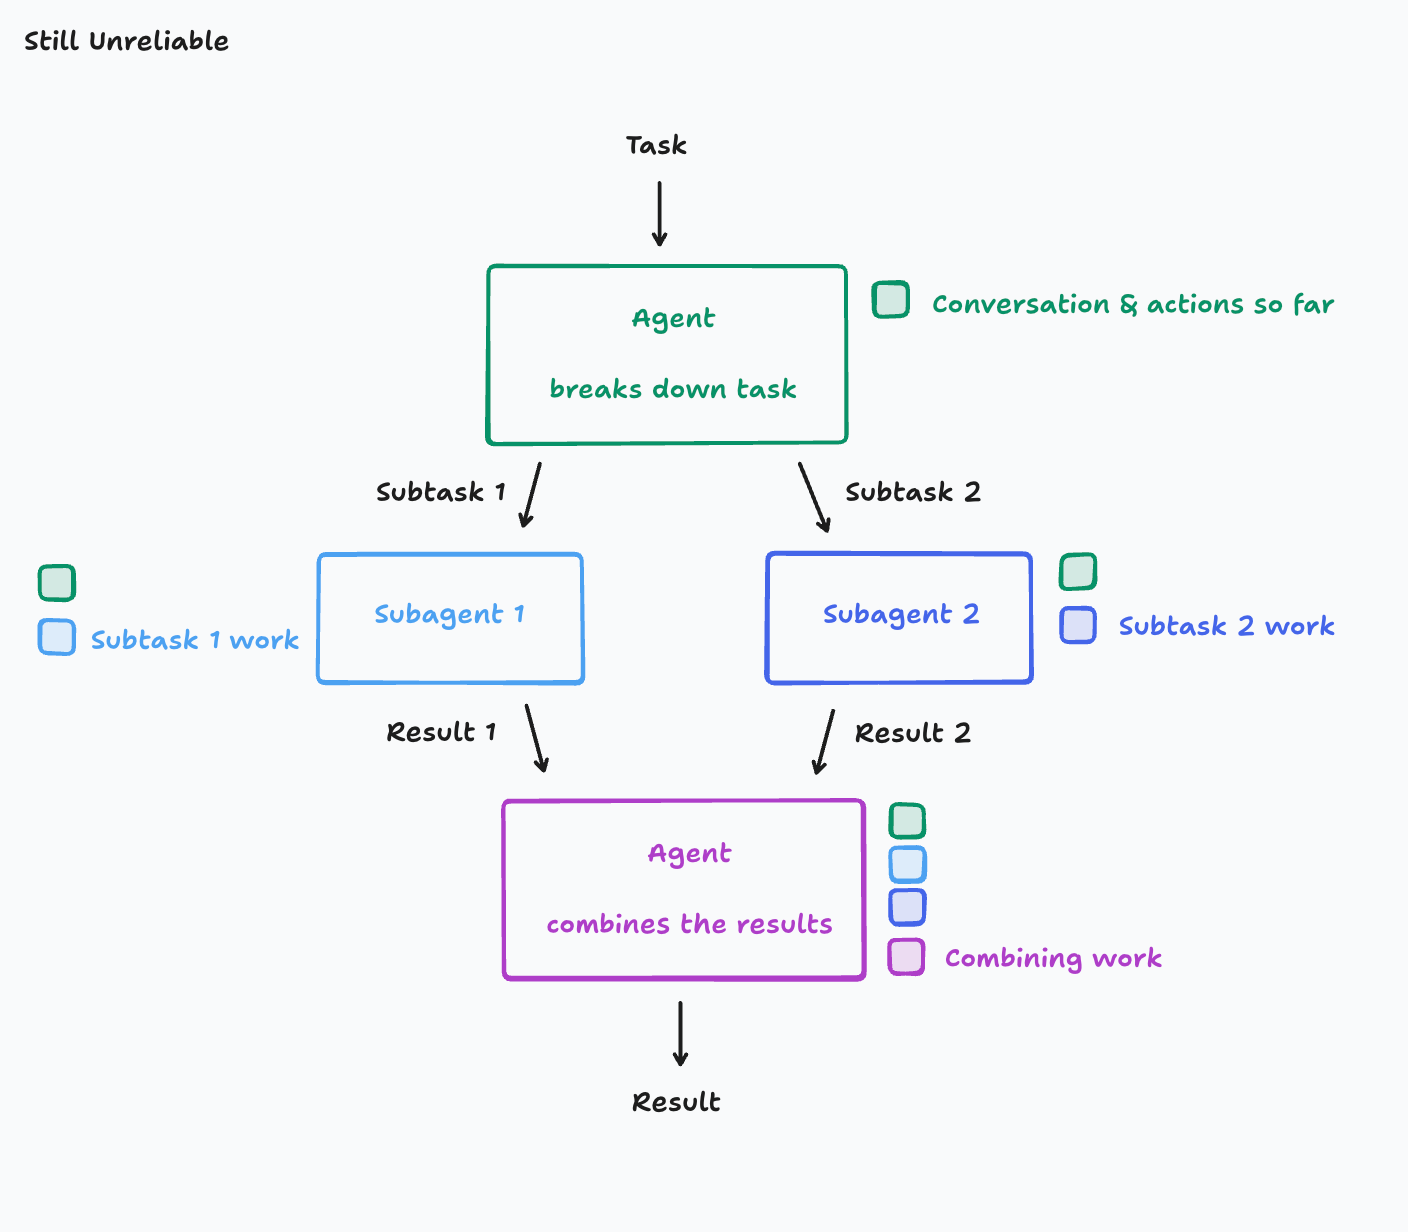
- 예시 분석: 모든 하위 에이전트가 전체 컨텍스트를 공유한다고 해도(예: 모두 《Flappy Bird》 클론을 만들어야 한다는 것을 안다고 하자), 서로 상대의 실시간 진행 상황을 볼 수 없는 채로 작업을 병렬로 진행하면 여전히 문제가 생깁니다.
- 하위 에이전트 1은 배경을 디자인할 때 특정 픽셀 아트 스타일을 선택할 수 있습니다.
- 하위 에이전트 2는 새를 디자인할 때 완전히 다른 만화 스타일을 선택할 수 있습니다.
- 결과: 결국 새와 배경의 시각적 스타일이 완전히 다른 《Flappy Bird》 클론이 만들어질 수 있습니다.
- 근본적인 이유: 하위 에이전트 1과 2의 행동은 사전에 명시되지 않았거나 실시간으로 공유되지 않은, 서로 충돌하는 가정에 근거합니다. 서로 상대가 무엇을 하고 있는지 볼 수 없기 때문에 결과적으로 두 작업이 서로 일치하지 않게 됩니다.
- 아키텍처 다이어그램:
2. 장시간 실행 에이전트 구축의 이론과 모범 사례
저자는 위의 두 원칙이 매우 중요하며, 이를 어길 이유가 거의 없다고 강조합니다. 따라서 에이전트 아키텍처를 설계할 때는 기본적으로 이 원칙을 지키지 않는 아키텍처를 배제해야 합니다.
1. 가장 단순하면서도 신뢰할 수 있는 아키텍처: 단일 스레드 선형 에이전트
- 아키텍처 다이어그램:
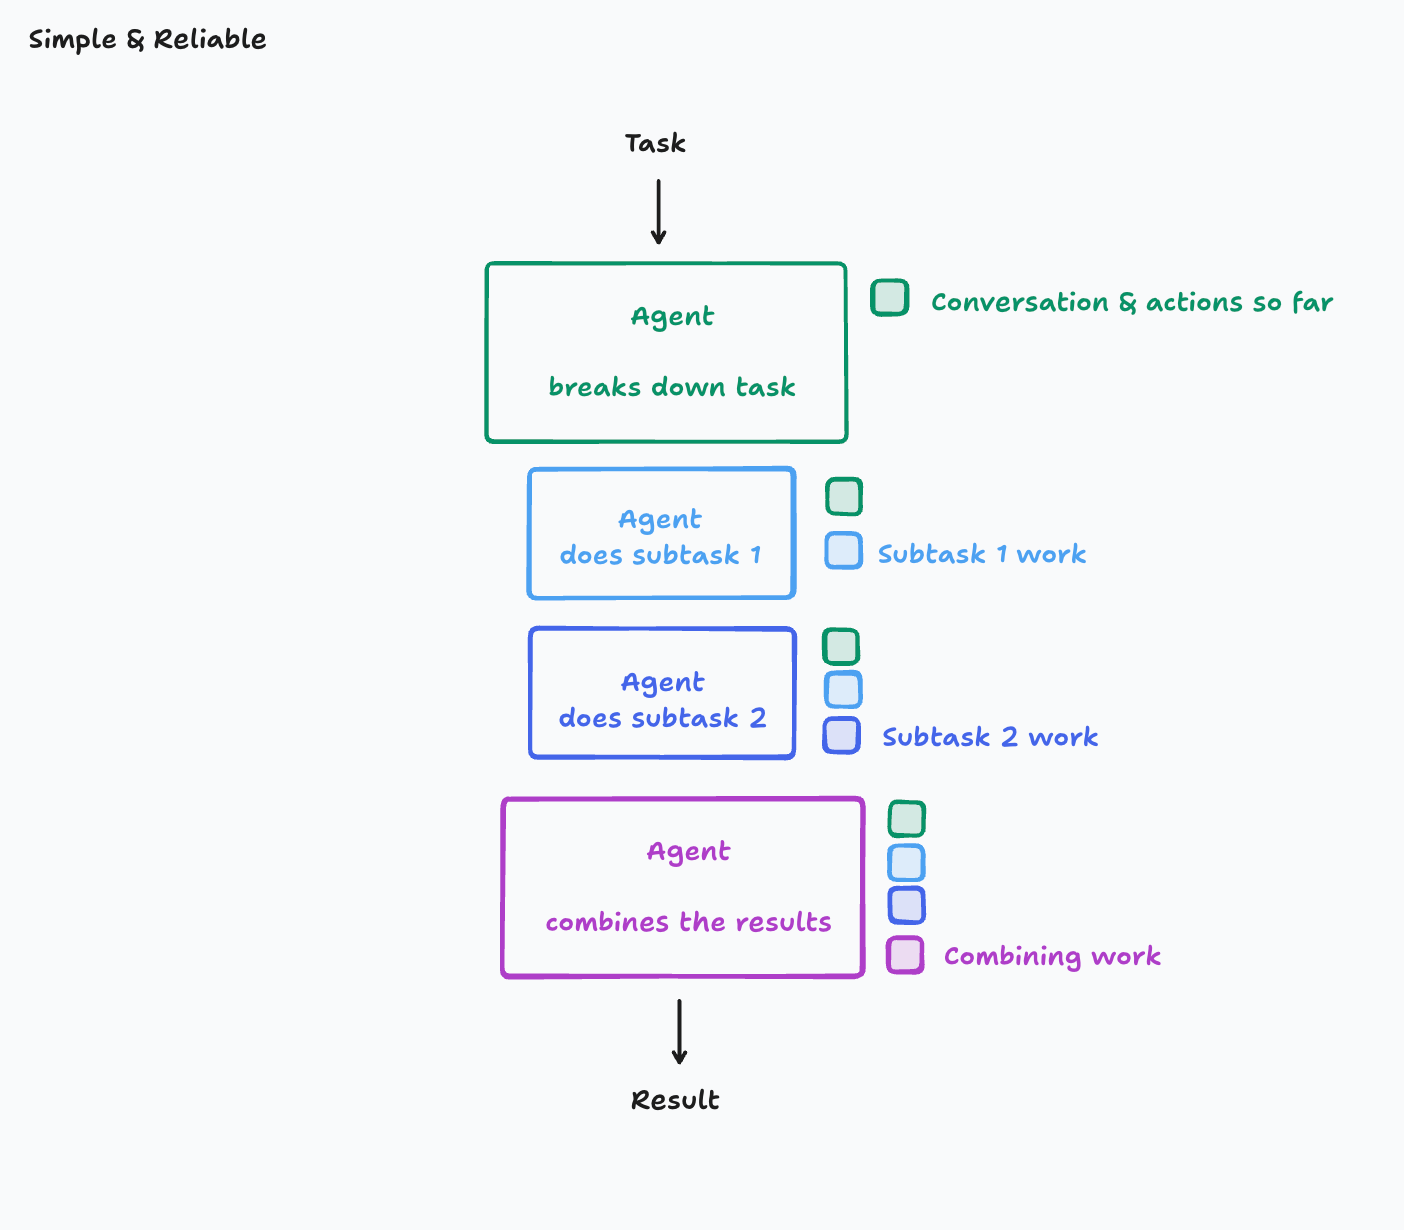
- 장점: 이 아키텍처에서는 컨텍스트가 연속적입니다. 각 단계에서 이전의 모든 대화, 결정, 도구 호출 이력에 완전히 접근할 수 있습니다. 덕분에 에이전트의 결정이 일관되며 신뢰성이 크게 높아집니다.
한계: 이 단순한 아키텍처는 매우 큰 작업을 처리할 때 컨텍스트 윈도우 초과가 발생할 수 있습니다. 작업이 진행될수록 기억하고 전달해야 하는 정보량이 급격히 늘어나 결국 LLM 모델의 컨텍스트 윈도우 한도에 도달합니다.
- 컨텍스트 윈도우 초과示意图:
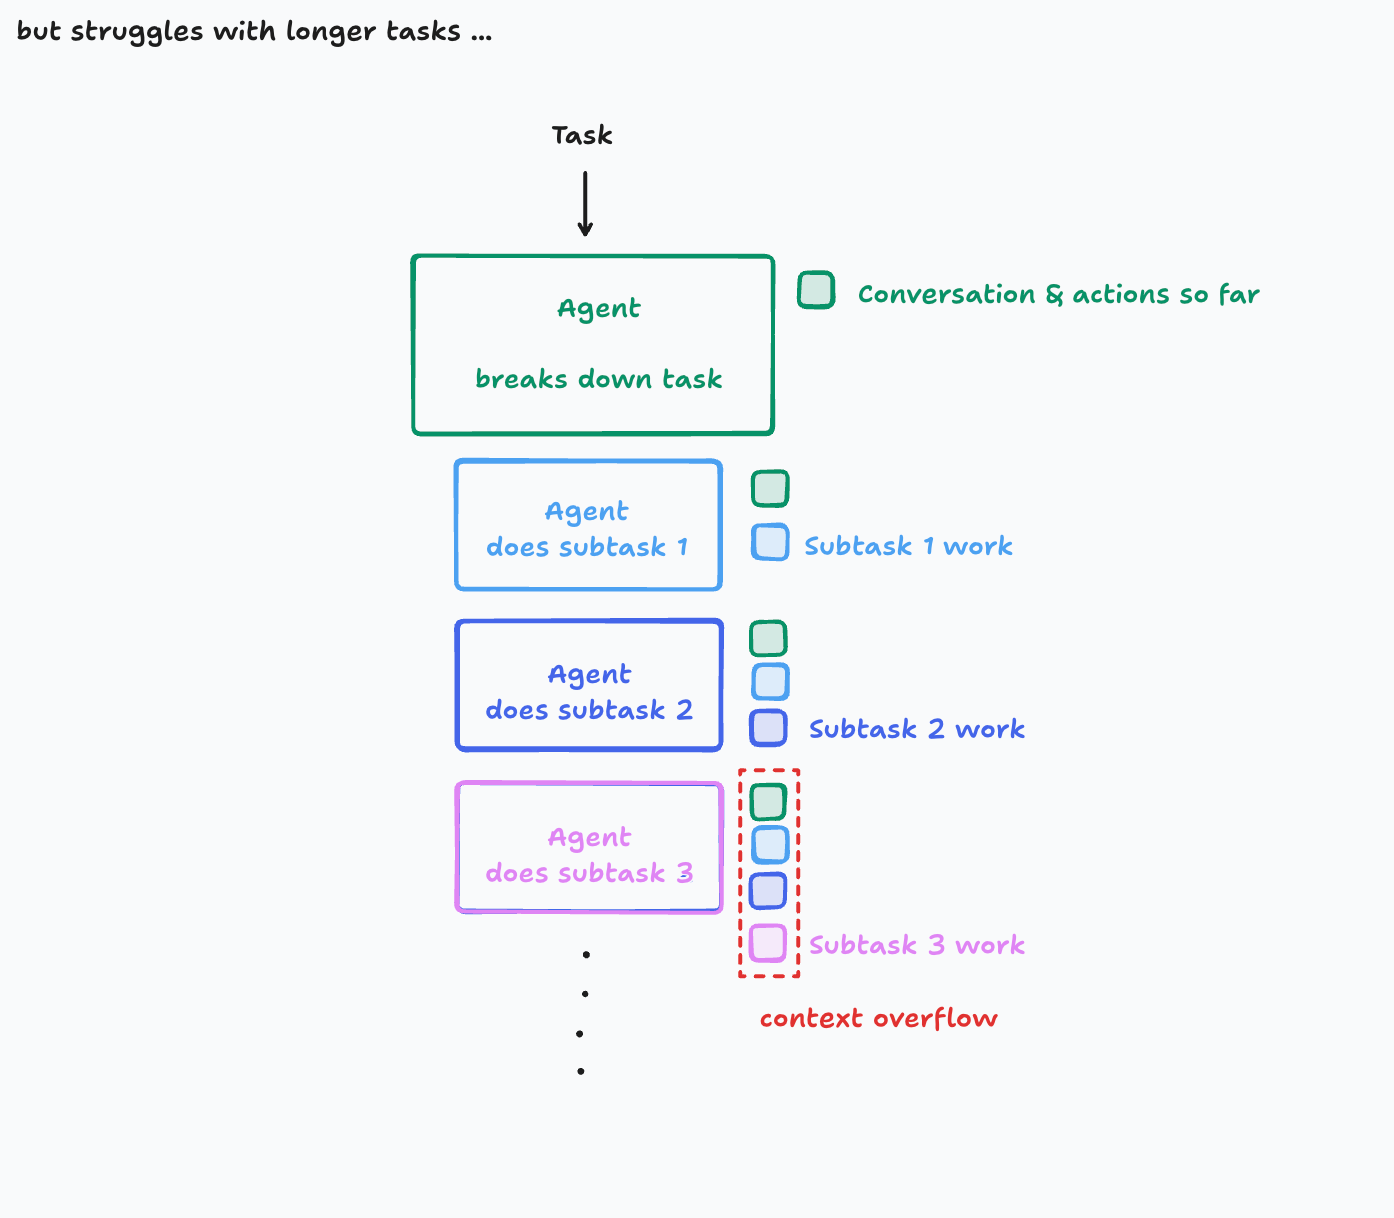
- 컨텍스트 윈도우 초과示意图:
2. 최적화 방안: ‘컨텍스트 압축’ 도입
- 아키텍처 다이어그램:
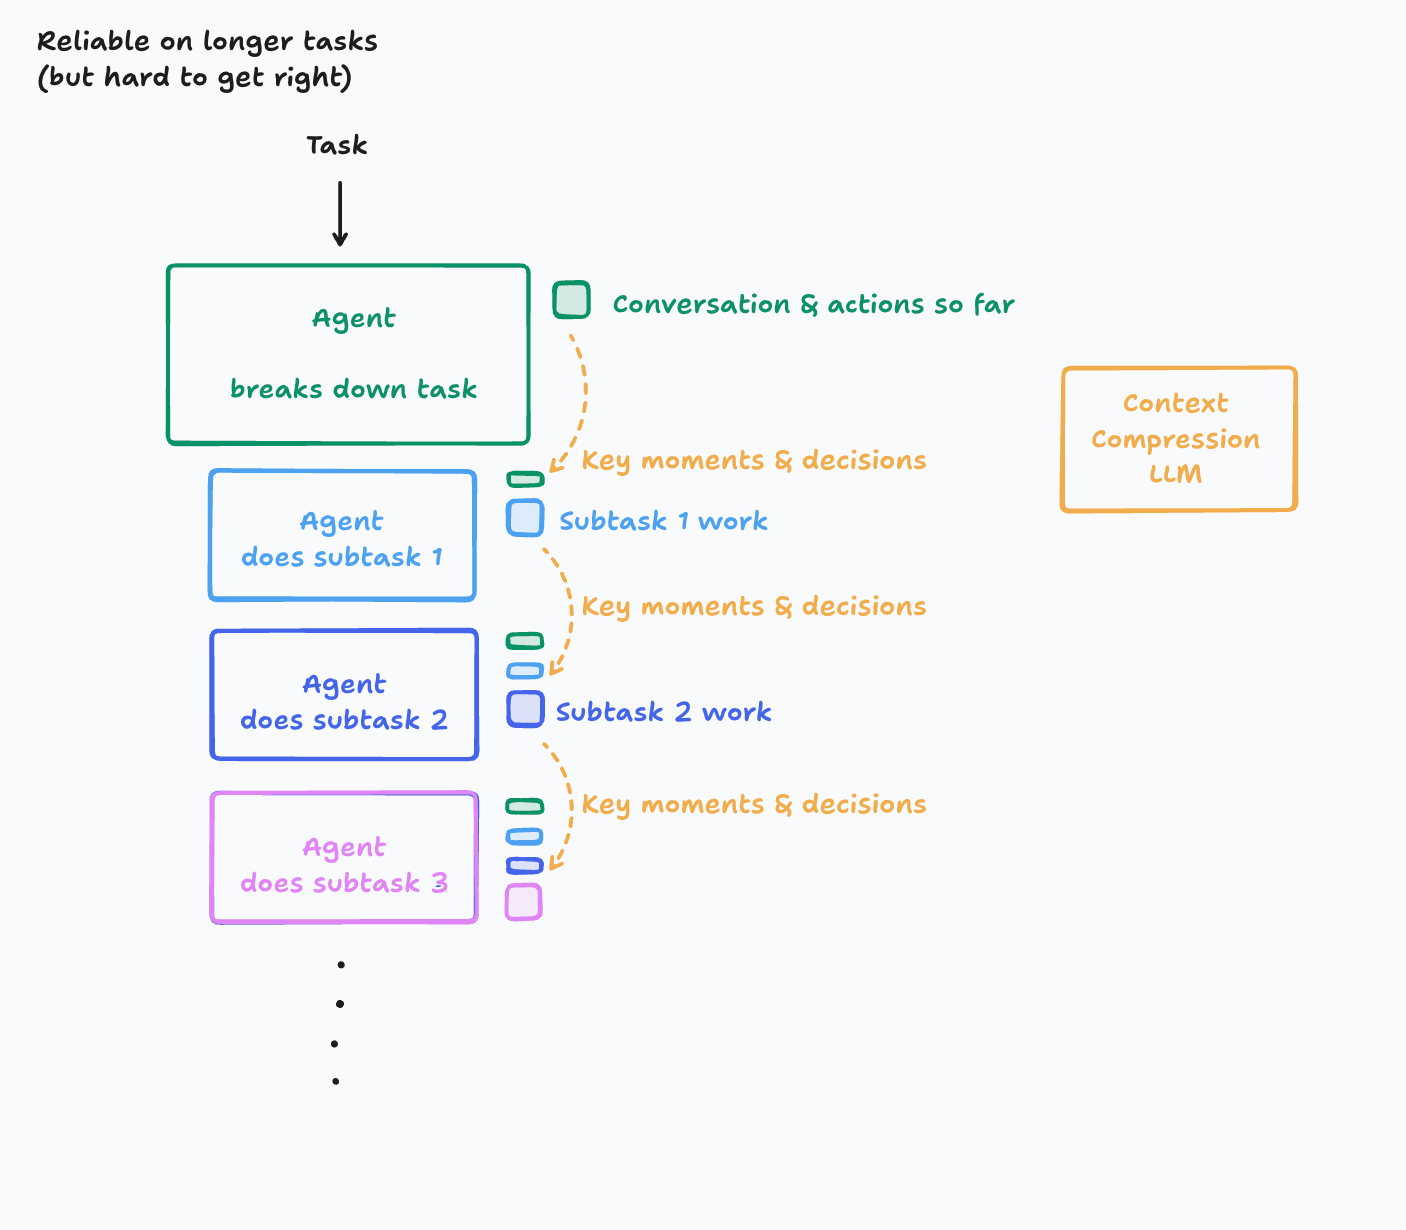
- 핵심 아이디어: 실제로 장시간 실행이 필요하고 컨텍스트가 매우 큰 작업에는 새로운 LLM 모델을 도입할 수 있습니다. 이 모델의 주요 목적은 과거의 행동과 대화를 압축해 핵심 세부 사항, 중요 이벤트, 주요 결정으로 정리하는 것입니다.
- 구현 과제: ‘핵심 정보’를 정확히 식별하고 추출하는 것은 매우 어렵습니다. 어떤 정보가 실제로 중요한지 이해하고 이 작업을 효율적으로 수행할 수 있는 시스템을 설계하려면 상당한 노력이 필요합니다.
- 구현 과제: 적용 분야에 따라 더 작은 모델을 파인튜닝해 컨텍스트 압축만을 맡길 수도 있습니다(Cognition 팀은 이미 그렇게 하고 있습니다).
- 이점: 이 방법을 사용하면 에이전트가 더 긴 컨텍스트에서도 유효하게 동작할 수 있습니다.
- 한계: 컨텍스트 압축을 적용해도 결국 한계에 도달합니다. 임의 길이의 컨텍스트를 어떻게 더 잘 관리할 것인가는 ‘꽤 깊은 토끼 굴’이며, 저자는 독자들이 이를 생각해 볼 것을 권합니다.
3. 원칙을 실제로 적용하기: 사례 분석
저자는 에이전트 구축자가 에이전트의 모든 행동이 시스템의 다른 부분에서 내린 모든 관련 결정의 배경을 충분히 이해하도록 해야 한다고 조언합니다. 이상적인 상태는 ‘모든 행동이 모든 것을 볼 수 있는 것’이지만, 컨텍스트 윈도우의 한계와 현실적인 절충 때문에 항상 가능한 것은 아닙니다. 기대하는 신뢰성 수준을 바탕으로 감당할 수 있는 복잡성을 결정해야 합니다.
적용 예시:
Claude Code의 하위 에이전트 전략:
- 현황: 2025년 6월 현재 Anthropic의 Claude Code는 하위 작업을 생성하는 에이전트의 사례입니다.
- 핵심 설계: Claude Code는 절대로 하위 작업 에이전트와 병렬로 작업하지 않습니다. 또한 하위 작업 에이전트에는 보통 구체적인 질문 하나에 답하는 작업만 배정되며, 코드를 작성하는 일은 전혀 포함되지 않습니다.
- 이유: 하위 작업 에이전트에는 메인 에이전트의 전체 컨텍스트가 부족해, 명확히 정의된 질문에 답하는 것 외에는 더 복잡한 작업(예: 코드 작성)을 수행할 수 없습니다. 여러 하위 에이전트를 병렬로 실행하면 서로 충돌하는 응답을 내놓을 수 있고, 앞에서 본 《Flappy Bird》 예처럼 신뢰성 문제가 생길 수 있습니다.
- 이점: 이 경우 하위 에이전트를 하나 사용하는 장점은 하위 에이전트가 수행한 모든 조사 작업(예: 정보 조회)을 메인 에이전트의 이력에 남길 필요가 없다는 점입니다. 그러면 메인 에이전트의 컨텍스트 기록을 더 오래 유지할 수 있어 컨텍스트를 너무 일찍 소진하는 일을 피할 수 있습니다.
- 결론: Claude Code의 설계자는 신뢰성을 보장하기 위해 의도적으로 단순화한 방식을 택했습니다.
‘편집-적용 모델’의 변화:
- 2024년의 일반적인 방식: 당시 많은 모델은 코드 편집 성능이 좋지 않았습니다. 코딩 에이전트, IDE, 앱 빌더(Devin 포함)는 널리 ‘편집-적용 모델’을 채택했습니다. 핵심은 대형 모델이 코드 변경 내용을 Markdown 지시문(예: “함수
foo를bar로 변경”)으로 출력한 뒤, 그 Markdown 지시문을 소형 모델에 입력해 실제 파일을 다시 작성하는 것이었습니다. 이 방식은 대형 모델이 형식이 올바른 diff를 직접 출력하게 하는 것보다 더 신뢰할 수 있다고 여겨졌습니다. - 문제점: 이 시스템들은 여전히 오류가 발생하기 쉬웠습니다. 소형 모델은 지시문의 아주 미세한 모호함만으로도 대형 모델의 지시를 잘못 이해해 잘못된 편집을 할 수 있습니다. 예를 들어, 대형 모델이 “함수
foo의 모든 호출을bar로 변경”이라고 했지만, 소형 모델은 그중 한 곳만 바꿀 수 있습니다. - 현재의 모범 사례: 이제는 코드 편집의 결정 수립과 실제 적용을 단일 모델이 한 번의 작업으로 처리하는 경우가 더 많습니다. 정보를 서로 다른 모델 사이에서 전달할 때 생길 수 있는 오해와 모호함을 피하므로 신뢰성이 높아집니다.
- 2024년의 일반적인 방식: 당시 많은 모델은 코드 편집 성능이 좋지 않았습니다. 코딩 에이전트, IDE, 앱 빌더(Devin 포함)는 널리 ‘편집-적용 모델’을 채택했습니다. 핵심은 대형 모델이 코드 변경 내용을 Markdown 지시문(예: “함수