スクリプト上なら正しいラベルを返せる識別器でも、サービスへ組み込むと別種の問題が生じます。タイムアウトしたリクエストが重複送信されることもあります。2つの応答が同じセッション状態を上書きし、ユーザーが日付を変更した後も、遅れて届いた結果が古いパラメータのまま実行されることもあります。
このような問題を処理するには、リクエストの受付から結果の保存までの一連の流れを追う必要があります。本文では、リクエストID、状態バージョン、冪等性、タイムアウト、キャッシュ、エラーサンプルの扱いを説明します。実行とテストに使えるローカルHTTPサービスも提供します。サービスと障害ケースをダウンロード
リクエストの重複排除、状態チェック、業務判断、原子的なコミットのフロー
一、リクエストAPIの設計
状態を持つ識別リクエストには、テキストに加えて、どのセッションに属するか、再試行であるか、どの状態バージョンを基に生成されたかを指定する必要があります。
session_idはセッションを特定し、request_idは1つの論理リクエストを識別し、expected_versionは呼び出し元から見た状態バージョンを表します。3つのフィールドは相互に置き換えられません。同じセッションには多くのリクエストがあり、同じリクエストを複数回送信することがあり、異なるリクエストが同じ古いバージョンを基に生成されることもあります。
実際のサービスでは、認証コンテキストからユーザーの身元を取得し、セッションと業務オブジェクトをその身元に結び付ける必要があります。リクエスト本文にあるユーザー自身の説明は、認証の代わりにはなりません。添付のローカル版では固定のデモIDを使用し、APIはループバックアドレスだけで待ち受けます。これにより、読み手が処理の流れを検証しやすくなります。
二、リクエストの冪等性と状態バージョン
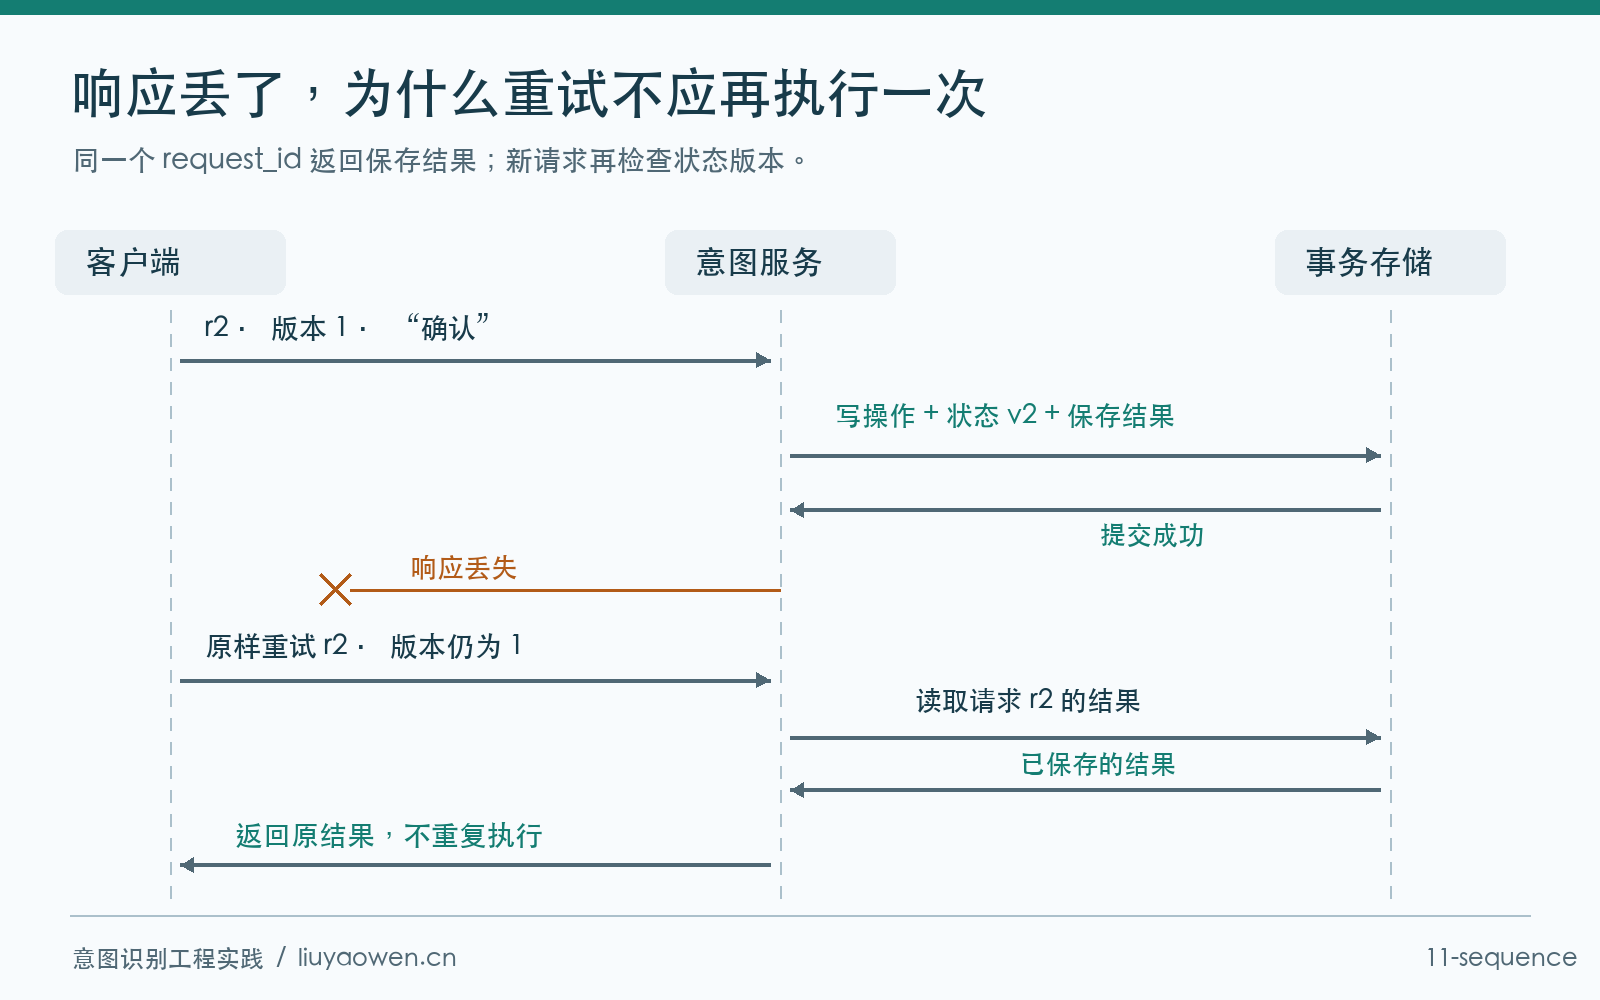
最初のリクエストは成功したものの、応答がネットワーク上で失われることがあります。クライアントが再試行するときは、元のrequest_idをそのまま使う必要があります。サーバーは、この論理リクエストが既に完了済みだと判断したら、保存済みの結果をそのまま返し、状態を再び更新したり注文をキャンセルしたりはしません。
同じリクエストIDで異なるテキストが送られる場合、それは通常の再試行ではありません。リクエストの主要フィールドのフィンガープリントを保存し、内容が異なる場合は競合を返すようにすれば、古い結果を新しい要望に誤って適用することを防げます。
状態バージョンは別のケースを扱います。異なる2つのリクエストがどちらもバージョン3を基にし、一方は日付を変更、もう一方は予約を確定する場合です。日付変更が先にバージョン4としてコミットされた場合、確定処理がバージョン4を上書きしてはいけません。条件付き更新では、現在のバージョンが引き続き3であることを明示的に要求し、満たさなければ競合を返して、クライアントに状態を読み直させます。
| 状況 | 適切な動作 |
|---|---|
| 同じリクエストID・同じ内容で、結果が保存済み | 元の結果を返す |
| 同じリクエストID・異なる内容 | 冪等性の競合 |
| 新しいリクエストIDで、状態バージョンが古い | 状態競合 |
| 新しいリクエストIDで、バージョンが一致 | 処理を続け、新しいバージョンをコミット |
チェック順序も重要です。通常の再試行で送る古いバージョンは、最初の成功リクエストによってすでに更新されている可能性があります。したがって、完了済みリクエストの記録を先に確認し、その後に新しいリクエストが古い状態を基にしているかを判断します。
三、トランザクションでデータ整合性を保証する
サービスが先に状態を更新し、その後で重複排除記録を保存する構成では、その途中でクラッシュする可能性があります。この場合、再試行時に同じ処理が実行され直す可能性があります。添付サンプルでは、セッション状態、リクエスト結果、監査イベント、模擬注文の操作を、同じSQLiteトランザクションに含めます。すべてが保存されるか、すべてがロールバックされます。
SQLiteはトランザクション、コミット、ロールバックのメカニズムを備えているため、これらの状態の整合性をデモするのに適しています。Python sqlite3ドキュメント
実際の注文システムは通常別サービスにあり、ローカルのデータベーストランザクションには直接参加できません。その場合は少なくとも論理操作IDをツールへ渡し、ツール側でも冪等性をサポートする必要があります。呼び出しがタイムアウトしたら、操作IDで結果を照会してから、再試行するかどうか判断します。必要に応じて、outbox、タスクステートマシン、結果の突合を使い、システム間の整合性を担保します。
特に「呼び出しが失敗を返した」と「業務操作が発生していない」は区別する必要があります。コミット後に接続が切れた場合、両者が異なることがあります。すぐ新しいリクエストIDに替えて呼び直すと、重複排除の仕組みを迂回し、重複した操作が発生します。
四、タイムアウトと再試行戦略を設定する
1リクエストの合計時間予算は2秒です。検索、モデル、ツールの各ステップが、それぞれ2秒待つようにしてはいけません。絶対的な期限時刻を保存し、各ステップで残りの時間予算を計算してから、続行するか、処理を簡略化するか、明確なサービス結果を返すかを決めます。
合計所要時間は、キューイング、状態の読み込み、識別、検索またはツールの実行、コミットと応答に分けて測定できます。分けないと、モデルを最適化してもユーザー体験が改善するかは分かりません。半分の時間がキューイングに費やされるなら、モデル推論だけを短縮する効果は限定的です。
再試行は残りの予算を消費するだけでなく、システムの負荷も増やします。再試行に適した場面は通常、一時的なネットワーク障害やサービス障害です。引数の誤り、権限拒否、状態競合では、通常はリクエストを変更する必要があります。指数バックオフとランダムジッターを使えば、大量のクライアントが同時に再試行するのを避けられます。それでも試行回数の上限を設定し、操作が再試行に適していることを確認する必要があります。AWSのタイムアウト、再試行、ジッターに関する説明
添付サンプルでは、単調増加するクロックを使って処理中の各ポイントで期限を確認し、予算を超えていればロールバックします。これは協調型の予算チェックです。ブロック中のネットワーク呼び出しには、依然としてクライアント側のタイムアウトが必要です。CPU上の推論を強制的に中止するには、中断可能な実行単位かプロセスの分離が必要です。リクエストの予算フィールドは、実際の実行時間を制限するために、これらの実行仕組みと組み合わせる必要があります。
五、トランザクションロックと並行制御
サンプルコードでは、リクエスト全体のローカル処理を1つのトランザクションに収めています。状態と注文シミュレーションを一緒にコミットする動作をデモしやすいためです。モデル推論が遅い場合、トランザクションがロックを保持し続けるため、同時実行数が多いサービスではトランザクション範囲を調整する必要があります。
実際のサービスでは、まず状態スナップショットを読み、昂贵的識別処理をトランザクション外で行います。その後はexpected_versionを使って、短いトランザクションでコミットできます。コミット時には必ずバージョンを再確認します。識別中に状態が変わっていた場合は、古いスナップショットに基づく結果を破棄するか、計算し直します。
書き込みを行うツールには、proposed、confirmed、executing、succeeded、failed、unknownのような、より細かなタスク状態が必要です。unknownは結果がまだ突合待ちであり、明確な失敗として扱ってはいけません。各状態を区別しておけば、復旧ロジックは、再呼び出し、結果の照会、ユーザー対応待ちのどれを選ぶべきか判断できます。
Python標準ライブラリのHTTPサーバーはローカルデモに使えます。本番環境では、認証、並行処理、接続管理、可観測性に適したサーバーを選び、リバースプロキシとリソース制限を設定してください。http.serverドキュメント
六、キャッシュキーと無効化戦略の設計
2人のユーザーが「1」と入力しても、選択される注文は異なることがあります。同じユーザーが続けて「明日を変更」と入力しても、変更対象タスクは異なることがあります。テキストだけをキャッシュキーにすると、ある文脈での解釈を別の文脈へ持ち越してしまいます。
キャッシュキーには、結果に影響する入力をすべて含める必要があります。現在のテキスト、必要な履歴または状態の要約、タグバージョン、モデルとPromptのバージョン、言語、ユーザーやテナントを分離するための適切な情報が候補です。要約が異なれば判断も異なるため、要約方針のバージョンもこのバージョン組み合わせに含める必要があります。
識別結果のキャッシュと業務結果のキャッシュも分離します。ポリシーの分類候補と注文の現在の状態では、キャッシュの有効期間も無効化の条件も異なります。「キャンセルを確認済み」という結果まで、無限に再利用できる確認キャッシュとして扱うことはできません。
身元の境界や状態への依存を明確にできない場合、キャッシュしないほうが、誤ったキャッシュを使うより保守しやすいのが通常です。まずコストのホットスポットを測定し、どの層をキャッシュするかを決めます。
七、サービス監視と業務指標
秒あたりのリクエスト数やエラーコードだけでは、モデルが問い合わせを操作としてルーティングしたことは見つけにくいです。観測は次の3つの視点に分けられます。
| 視点 | 注目する項目 | 用途 |
|---|---|---|
| サービス | レイテンシ分布、タイムアウト、キューイング、依存先の障害 | 実行時のボトルネックを特定 |
| 判断 | ラベル分布、拒否、澄清、上位モデルへのエスカレーション率 | 入力と戦略の変化を観察 |
| タスク | 完了、放弃、人手による対応、重複操作、誤操作 | 実際の利用結果を判断 |
リクエストごとにラベル、モデル、Prompt、ルート、状態バージョンを記録すると、変更を特定のリリースに対応付けられます。ログには診断に十分な構造化フィールドを保存します。元の会話内容は、明示的な権限設定、マスキング、保持方針に従って扱ってください。すべてのチャットや業務パラメータをデフォルトで公開ログへ書き込むべきではありません。
ローカルサンプルの監査テーブルには、セッションID、リクエストID、バージョン、ルート、所要時間だけを保存します。本番環境ではさらに、trace ID、ツール操作ID、ユーザーのフィードバックを関連付け、サービス全体をまたぐリクエストチェーンを構築できます。
八、エラーサンプルのレビューとバージョン公開
ユーザーによる「キャンセルする意図ではない」という訂正は、価値のあるエラー信号です。とはいえ、コンテキストを確認する必要があります。モデルが誤解したのか、画面の表示が不明瞭だったのか、それともユーザーが一時的に要望を変えたのか。
まず信号を集め、エラー種別ごとにグループ分けして、ラベルと想定される操作をレビューし、学習用または回帰テスト用データに追加します。本番上の失敗をすべて自動的に単一カテゴリへ分類すると、ツール障害、プロダクト上の問題、ユーザーの要求変更が、識別の学習データへ混ざります。
リリース時には、ラベル、データ、Prompt、モデル、しきい値、ルートを含むロールバック可能なバージョンセットを保存します。シャドーモードでは新旧の出力だけを比較し、新しい方式による業務データへの書き込みは行いません。段階公開では実際のトラフィックを少しずつ有効にし、コストの高いエラーを継続的に監視します。モデル更新後は、業務フロー全体を検証する必要があります。
九、HTTPサービスの起動とテスト
python batch3/service.py --db /tmp/intent-demo.sqlite3 --port 8765
別のターミナルでリクエストを送信します。
システムはまずconfirmを返します。新しいリクエストID、返されたバージョン、テキスト「确认」を指定して続行すると、シミュレーション操作が完了します。まったく同じ確認リクエストを再度送った場合は、最初に保存された結果が返ります。
自動チェックも直接実行できます。
python batch3/tests.py
python batch3/http_smoke.py
今回の実際のループバックHTTPチェックでは、提案と確認が成功して200が返されました。元のリクエストの再送では同じ結果が返りました。古いバージョンを使う新しいリクエストは409でした。同じIDで内容を変えたリクエストも409でした。余分なフィールドがある場合は400でした。障害テストでは、タイムアウト時のロールバック、注文バージョンの変更、料金条件の変更、再起動後の状態復旧も確認しました。
次の記事、完全なアシスタントプロジェクトでは、タベル、識別、状態、ルーティング、およびこれらのサービス側の制約をつなぎ、インストールから完全な会話までの実行経路を示します。