1. 研究の背景と動機
コントラスト学習は代表的な自己教師あり表現学習の手法であり、その基本的な考え方は「類似したサンプルのペア(正サンプルペア)」を引き寄せ、「異なるサンプルのペア(負サンプルペア)」を遠ざけることにあるarxiv.org。代表的な手法であるInfoNCE損失は、同一画像に由来する2つの拡張ビュー間の類似度の上限を、異なる画像のサンプル間では相違度の下限を課すarxiv.org。InfoNCEなどのコントラスト損失は、画像認識の事前訓練などのタスクで大きな効果を上げているarxiv.org。一方で、いくつかの限界もある。まず、各サンプルについて正サンプルペアを作る必要がある(通常はデータ拡張で得る)。さらに大量の負サンプルを維持する必要があるため、訓練が複雑になり、メモリ消費も大きくなるarxiv.org。次に、この方法を生成モデル(拡散モデルなど)に直接使うと、正サンプルペアを定義しにくい。拡散モデル自体の訓練はノイズ除去の回帰を目標としているため、さらに別のビュー変換を加えると本来の訓練フローを乱す可能性があるarxiv.org。実際、拡散生成モデルが通常依存するのは回帰損失だけで、表表現を明示的に正則化していないarxiv.org。これは画像認識分野で表現学習を重視する取向とは対照的だarxiv.org。
この問題に対して、研究者はDispersive Loss(分散損失)を提案した。追加の正サンプルや事前学習モデルなしで自己教師あり正則化を導入し、モデル内部の表現をより豊かにすることが一方の目的である。もう一方の目的は、拡散モデルの訓練フローを「軽量」かつ「自己完結」に保つことだ。そのためDispersive Lossは、内部特徴を「離散化/拡散」する正則項として設計された。従来のコントラスト損失で「異なるサンプルを遠ざける」作用だけを残し、「同じサンプルを引き寄せる」作用は捨てているarxiv.orgarxiv.org。
2. 方法の紹介
Dispersive Lossの中心的な考え方は、生成モデルの中間特徴を正則化し、表現空間の中でできるかぎり「分散」させることにある。具体的には、1バッチ分の入力サンプルとそれに対応する中間表現${zi}$に対し、全体の損失関数は既存の回帰損失$L{\rm diff}$(拡散モデルのノイズ除去MSEなど)と、新しく加えた分散損失$L_{\rm disp}$から次のように構成される:
ここで$\lambda$は分散損失の重みを制御するarxiv.org。Dispersive Lossはモデルの中間活性化値に直接作用し、射影ヘッドや追加の学習可能パラメータを一切必要としないarxiv.org。この設計によって方法の自己整合性が保たれる。$\lambda=0$ならモデルは元のベースラインに退化し、$\lambda$が0でなくても既存の訓練フローは変わらない。追加のデータ拡張やビューサンプリングも不要だarxiv.org。要するに、Dispersive Lossは「正サンプルなしのコントラスト損失」という自己教師あり目標である。回帰損失そのものが、各サンプルを整合させる目標(正サンプル)をすでに与えているため、遠ざける作用だけを残せばよいarxiv.org。 InfoNCEを例にすると、元のInfoNCE損失は次のように形式化できる:
ここで$zi$と$zi^+$は同じサンプルの2つのビュー表現、$d(\cdot,\cdot)$は類似度(負コサイン距離など)、$\tau$は温度係数を表すarxiv.org。この損失には、正サンプルを引き寄せる作用(分子項)と、負サンプルを遠ざける作用(分母項)の両方が含まれている。Dispersive Lossを構成する際、研究者は正サンプルの項を捨て、遠ざける部分だけを残す。具体的には、すべてのサンプル表現についてペア間距離を求め、その対数平均を取ることで、InfoNCE形式の分散損失が得られる(論文のEq.6):
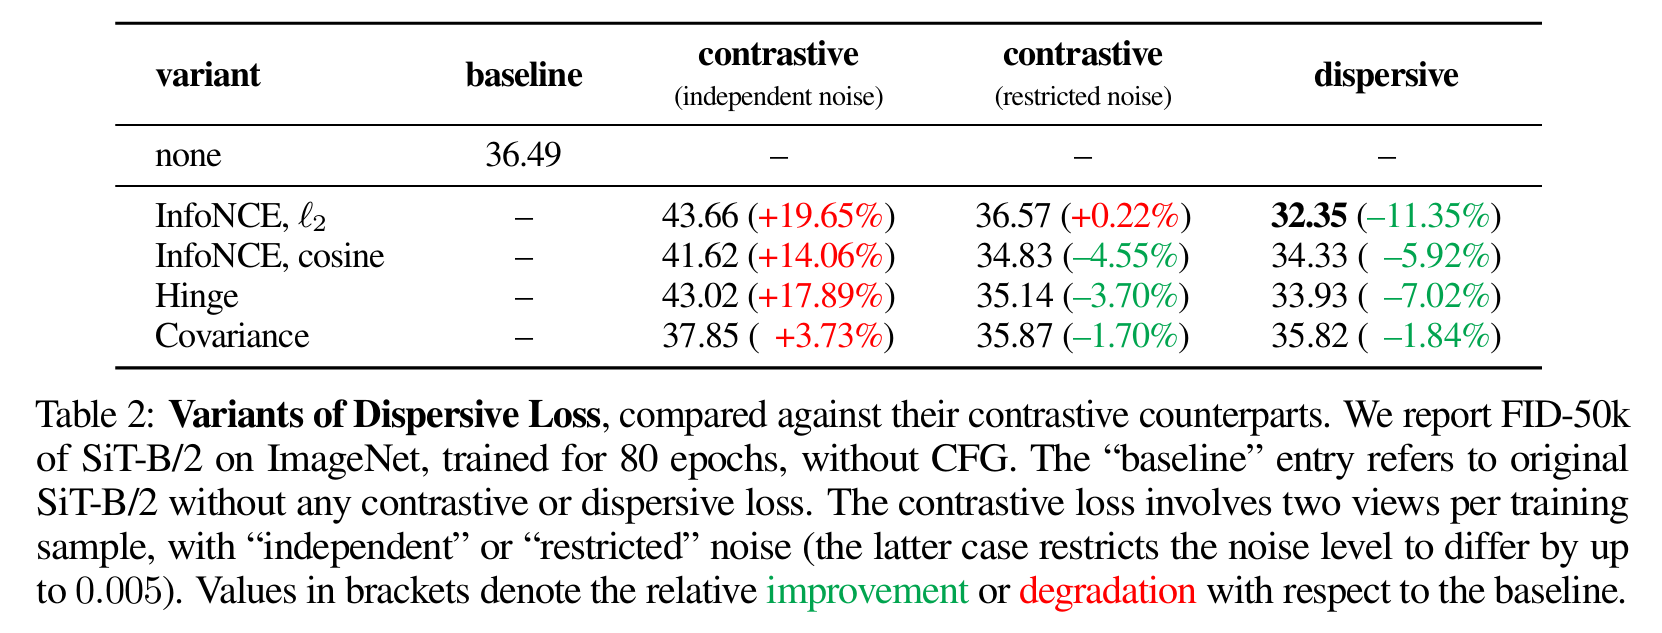
この式は、バッチ内の任意の2サンプル間距離の平均を取り、その平均の負の対数を取ったものと同値であるarxiv.org。直感的には、この損失はすべてのサンプル表現間の距離が大きくなるよう促し、特徴量ベクトルを空間内に一様に分布させる(「Uniformity」目標に似ている)arxiv.org。著者は、負サンプルだけを残すHinge損失やCovariance損失などの変種も紹介している。いずれもDispersive Lossのインスタンスとして扱えるarxiv.orgarxiv.org(表1に変種がまとめられている)。実験結果では、InfoNCEの距離に基づく形式が通常は最良だったarxiv.org。
元のコントラスト損失と比べて、Dispersive Lossにはいくつかの顕著な違いがある:
- 正サンプルもデータ拡張も不要:各画像について2つ目のビューを構築する必要がなく、データ拡張が生成モデルの訓練を乱すことを回避できるarxiv.org。
- 軽量で自己完結:外部の事前学習モデルにも追加パラメータにも依存しない。REPAのように表現を整合させる手法とは異なり、Dispersive Lossは完全にモデル自身の内部表現に基づくarxiv.org。
- 明確な目標:サンプル間の「反発力」を強めて特徴を分散させることに集中するarxiv.orgarxiv.org。正例間の整列は回帰損失に任せ、自動的に行わせる。
3. 実験設計と結果
著者はImageNet-1K(256×256)データセットで、異なる規模のSiT(Score Distillation Transformer)やDiTモデルなど、複数の拡散生成モデルを検証したarxiv.orgarxiv.org。ベースラインモデルは標準的な拡散回帰損失だけを使い、Dispersive Lossを加えたモデルと比較した。評価指標はFID-50k(ImageNetでqzEKlyqo画像品質指標)だ。
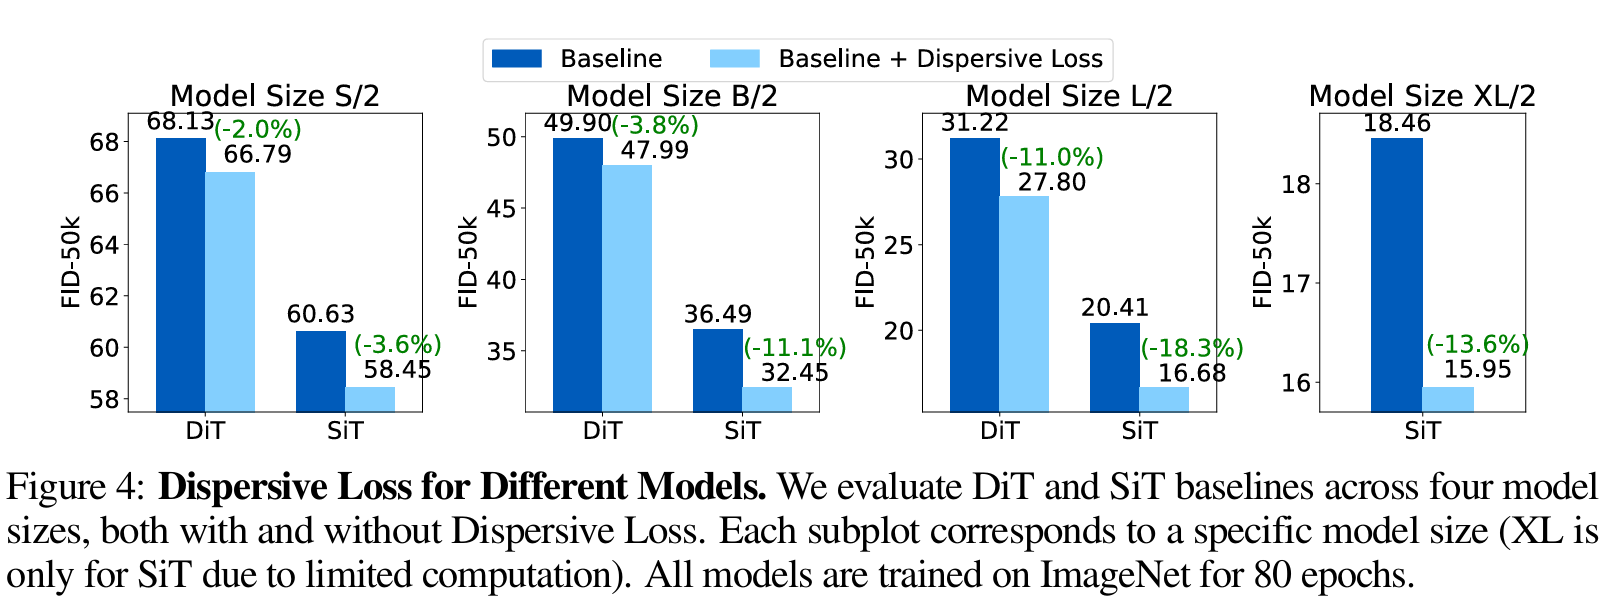
- 全体的な改善:実験結果は、Dispersive Lossを加えたすべてのモデルで品質が向上したことを示している。SiT-B/2(80エポックの訓練)を例にすると、ベースラインのFIDは36.49、Dispersive Lossを加えると32.35になり、相対的に11.35%低下したarxiv.org。より大きなSiT-XL/2では、80エポックの訓練終了時に、classifier-freeガイダンスなしのFIDが18.46から15.95へ13.6%低下した。classifier-freeガイダンスありでも同様の改善が見られ(6.02→5.09、-15.4%)、結果はarxiv.org。この改善は異なるモデル規模(S/B/L/XL)やエポック数でも一貫して現れているarxiv.orgarxiv.org。
- アブレーション実験:著者は異なる変種とハイパーパラメータを解析した。InfoNCE(距離ベースまたはコサインベース)、Hinge、Covarianceなど、異なる形式のDispersive Lossを比較した(表2)。結果として、すべての変種が正則化を使わないベースラインを上回り、InfoNCEの距離形式が最良だったarxiv.org。さらに、Dispersive Lossをネットワークの異なる階層(Transformerのblock)に適用してもFIDは低下し(表3)、すべての層で正則化した場合に最大の利得が得られたarxiv.org。また、正則化の重み$\lambda$と温度$\tau$の選択は結果にほとんど影響せず、広い範囲でいずれも明らかにベースラインを上回ったarxiv.org。
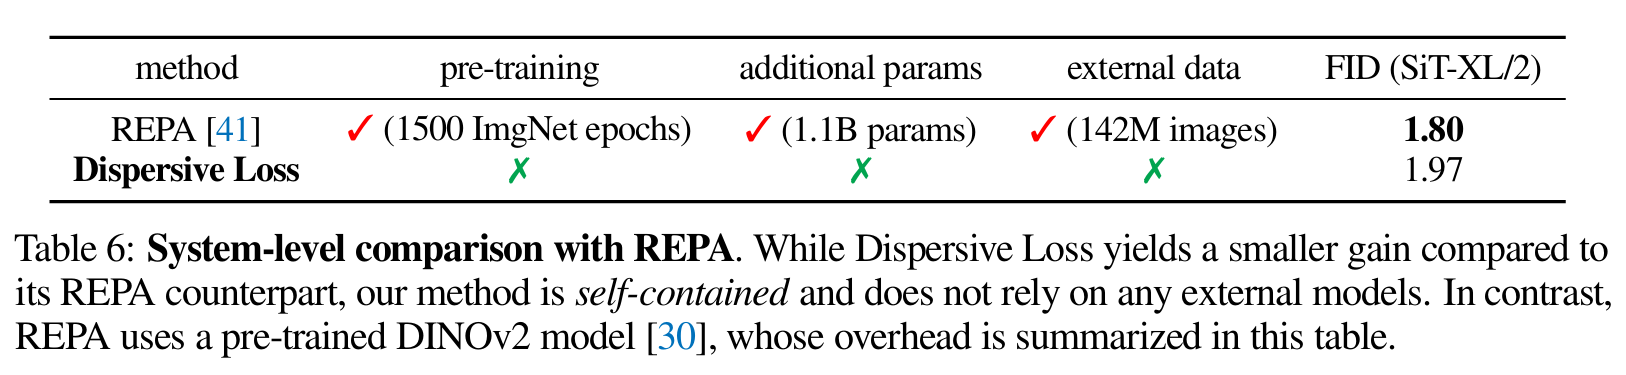
- 他手法との比較:Dispersive LossはREPAなどとも比較された。REPAは表現を整合させるために外部の事前学習モデル(1.1BパラメータのDINOv2など)を使うが、Dispersive Lossは完全に自己完結しており、追加データは不要だ。具体的にはSiT-XL/2の実験で、Dispersive LossのFIDは1.97、REPAが報告した対応値は1.80だったarxiv.org。後者のほうがわずかに低いものの、Dispersive Lossは外部モデルも外部データも使わないことを考えると、コストパフォーマンスに優れるarxiv.orgarxiv.org。
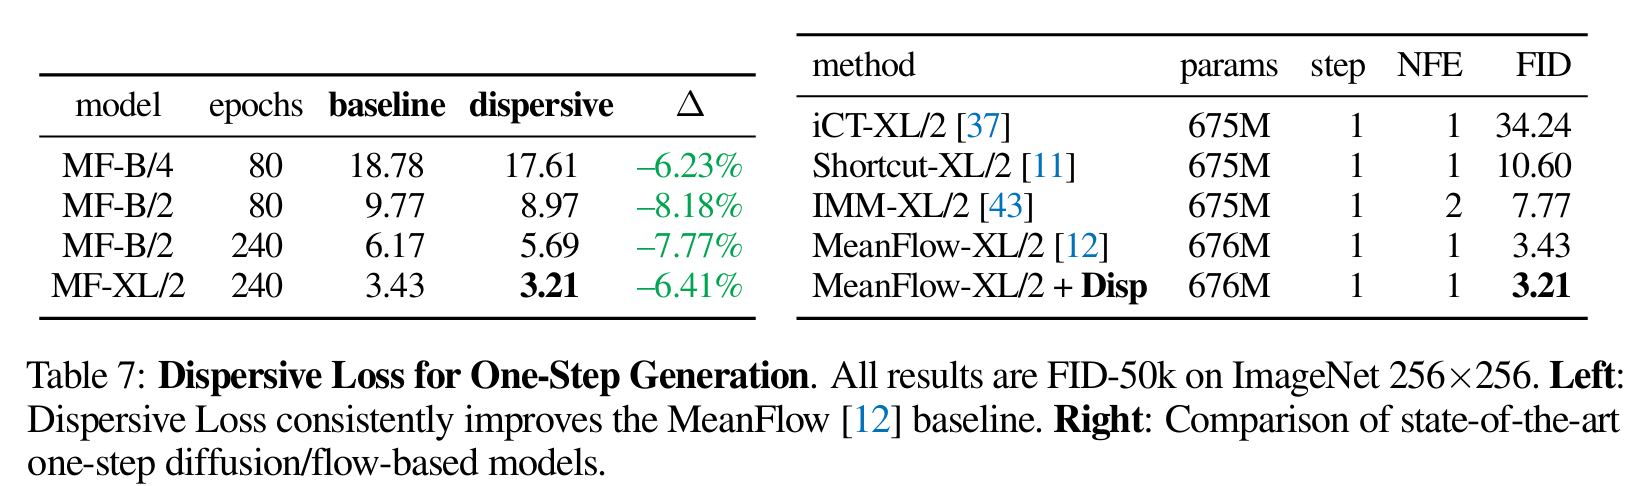
- 単一ステップ生成のテスト:著者は最新の単一ステップ拡散フレームワークMeanFlowにもDispersive Lossを適用した。実験結果(表7)では、MeanFlow-XL/2にDispersive Lossを加えるとFIDが3.43から3.21へさらに下がり、単一ステップ生成の最良水準を更新したarxiv.org。この方法は複数ステップのモデルだけでなく、単一ステップ生成の品質も高められることを示している。
全体として、各実験はDispersive Lossの有効性を一貫して示している。異なるデータセット、モデル規模、訓練条件のいずれでも生成品質が大幅に改善され(FIDは10%余り低下)、従来のコントラスト損失を直接加えると逆に性能が低下する可能性があるarxiv.orgarxiv.org。
4. 意義と影響
Dispersive Lossは、表現学習と自己教師あり学習の領域に新しい考え方と貢献をもたらした。まず、「正サンプルなし」のコントラスト学習フレームワークを提案し、負サンプル(またはその等価な形式)のみを使って学習することを強調したarxiv.orgarxiv.org。この点は以往の研究では比較的に少なかった。既存研究には「負サンプルなし」(BYOLなど)のコントラスト学習がある一方、Dispersive Lossは「正サンプルなし」のコントラスト学習という新たな方向を開いたarxiv.orgarxiv.org。理論的には、従来のInfoNCEの整列(alignment)部分を別の目標に任せ、均一性(uniformity)の正則項だけを残すことに相当する。表現学習における整列と均一性のトレードオフを理解するための新しい視点を提供している。
次に、応用面では、Dispersive Lossは自己教師あり正則化によって生成モデルの品質を大幅に高められることを示した。しかも実装は驚くほど簡潔で、追加データも事前学習も複雑なアーキテクチャも不要だ。訓練中に特徴を「分散させる」損失項を1つ加えるだけでよいarxiv.org。この自己整合的で軽量な設計により、既存の生成モデル訓練パイプラインに統合しやすい。大規模モデルの訓練ではこの正則化が特に重要になる。著者は、より強い基盤モデル(より大きなTransformerなど)がDispersive Lossから大きな利益を得ることを観察したarxiv.org。これはDispersive Lossが追加の正則化項として過学習を防ぐことを示している。実際には、Stable DiffusionやDALLEのような大型生成モデルを訓練する際にも、同様の分散正則化手法が生成品質を改善する可能性がある。
最後に、この研究はより大きな視点から生成モデルと表現学習の融合を促した。著者はDispersive Lossによって「生成モデリングと表現学習の間のギャップを埋める」ことを望んでいるarxiv.org。具体的には、自己教師あり学習の考え方を生成タスクへ導入し、生成モデル内部に多様な表現を明示的に学ばせる仕組みを提供した。また、この手法の汎用性(さまざまなモデルやタスクに適用できる)は、正サンプル対を事前に定義しない他のタスクでも同様の正則化を検討できることを示唆している。自然言語生成や強化学習における特徴表現などがその例である。
まとめ:Dispersive Lossは、新しい、かつ使いやすい表現学習の損失を提案し、コントラスト学習の「異なる要素を遠ざける」仕組みを取り出して単独で適用することで、モデル内部の表現を豊かにする。この方法は画像生成タスクで大きな改善を生み、その有効性を確認した。同時に、簡潔で自己完結している特点是幅広い適用可能性を秘めており、自己教師あり学習と生成モデルの研究に新たな方向を開くarxiv.orgarxiv.org。